签名验证到底使用SortedMap、LinkedHashMap、HashMap中的哪一个

技术岛公众号

技术岛公众号

最近同事发现有接口签名验证通不过,查了许久,发现,两边的验签规则不一样。最大的差异在于时间戳是否参与参数的排序。使用较多的版本是时间戳参与参数排序,而突然出一个接口中的时间戳不参与排序,导致算出来的签名值不一样。让我们使用一段main方法来感受一下其中的差异。

storm与财富增值

代码堆得好不如财富增值好

public static void main(String[] args) {

System.out.println(“SortedMap”);

SortedMap<String, String> sortedDict = new TreeMap<>(Collator.getInstance());

sortedDict.put(“B”, “B”);

sortedDict.put(“A”, “A”);

sortedDict.put(“C”, “C”);

System.out.println(sortedDict);

System.out.println(“LinkedHashMap”);

Map<String, String> dic = new LinkedHashMap<>();

dic.put(“B”, “B”);

dic.put(“A”, “A”);

dic.put(“C”, “C”);

System.out.println(dic);


System.out.println(“HashMap”);

Map<String, String> hashMapDic = new HashMap<>();

hashMapDic.put(“B”, “B”);

hashMapDic.put(“A”, “A”);

hashMapDic.put(“C”, “C”);

System.out.println(hashMapDic);

}

输出的结果:

SortedMap

{A=A, B=B, C=C}

LinkedHashMap

{B=B, A=A, C=C}

HashMap

{A=A, B=B, C=C}

很显示,当我们使用SortedMap、HashMap来处理签名参数的时候,参数自动排序了,而当我们使用LinkedHashMap处理的时候参数则不会排序。

造成问题产生的原因,看起来是使用了LinkedHashMap导致的,仔细分析,完全是两种签名处理思路导致的。

推荐思路一:使用SortedMap、HashMap做预处理,与顺序无关

不推荐思路二,没有对url中的query参数做任何预处理,直接在尾部附加上了时间戳,省了一步参数预处理。

思路二的问题在于,参数的顺序会影响最终签名,调用方需要知晓参数顺序。如果大家都知道并严格执行签名顺序,思路二其实也是正常的可行的。但是一般来讲,团队成员可能不断变化,一不留神就掉进这个洞里了。推荐使用思路一进行签名验证。

思路一与思路二的验证方式如何对接上呢?

在思路一追加时间戳之前,需要创建一个LinkedHashMap,将处理过的参数put进去,再将时间戳put进去,之后生成的签名URL就与思路二是一致的。

小结:当我们设计接口签名规则时,可以遵循一下一个重要的规则,参数顺序无关。

签名参考流程:

1.参数提取,记得使用SortedMap或HashMap

2.过滤处理

3.生成待签名URL

4.签名

5.生成签名后的URL

巧妙拆分bolt提升Storm集群吞吐量

技术岛公众号

技术岛公众号

发表在 未分类 | 留下评论

搞技术的公司用上这几个工具 研发运维开心指数暴涨

这篇文章适合在小公司成长的小伙伴,如果你恰好看到了,赶紧给自己的公司部署上这几个小工具,你会发现,省下了很多宝贵时间。将研发从代码开始就管理起来,嗯,就是这么神奇哦。

在小公司有这么个特点,一个人要干的活超级多,有些活非常繁琐,而且经常要干,占用了很多琐碎的时间,投入产出比低就不说了,主要是天天重复做,心如刀割,比如说代码管理,上线发布,代码质量检查等等。回想一下自己用的什么工具在管理代码、用的什么工具自动部署?今天要推荐的这个工具组合,能让代码管理、发布、部署做到质量管理、自动化。没有重复造轮子,有兴趣自己造轮子的,可以尝试一下。

No.1 Jenkins

在Jenkins中建立构建任务,把代码从GitLab上拉取下来,构建,Jenkins与sonarcube集成,进行代码质量检查,完成测试环境发布,将构件发布到自动部署的约定位置。

No.2 sonarqube

sonarqube is 我见过的最强大的代码质量检查工具了,能分析起各种坏味道,bug,不合理的代码编写,内置了很多检查规则,使用sonarqube可以让团队的代码编写统一规范,而且可以防止一些低级的写法出现。当然,配置sonarqube的检查规则的时候,最好也依据团队的编写做些小小的适应调整,比如写习惯了UserBLL会报上坏味道,要求写成UserBll,有结小小的不爽,是吧。统一规范就是舍去的过程,建立好了检查规范,大家都用sonarqube执行严格的代码检查,就好了。

No.3 gitlab

之前使用tfs,svn,后来被带入gitlab,使用gitlab,觉得使用git也不错哦。给自己的公司部署一个Gitlab,严格管理主干分支,新人在分支上玩,发起merge请求,合并主干,一下子管理就规范多了。

No.4 自动部署系统

可以自己DIY一个,也可以找个开源的,前几天有看到一个国内的小伙伴开源了一个自动部署系统,在这里就不推荐了。使用Jenkins构建完的war包,jar包,dll,可以使用自动部署系统管理起来,发布的时候,点一下,回滚的时候再点一下。

后记,自动部署系统可以对接上云主机、物理机、docker,嗯嗯~这么一套强大的系统,结合了Jenkins\sonarqube\gitlab,就是让小伙伴的时间能省下来。一定不要觉得前配置麻烦,这些工具配置好之后,后面就可以开心的玩耍了!

这么一套工具怎么配置,怎么才能搭建一套呢?回复公众号【研发工具】索取!

巧妙拆分bolt提升Storm集群吞吐量

技术岛公众号

技术岛公众号

发表在 未分类 | 留下评论

魔高一丈 道高一尽 帐号泄漏攻守之战 多传的Account 为友商提供了天然信息 早发现早处理 保护用户隐私 构建强有力安全环境

今天遇到了两个非常典型的互联网运营平台安全风险问题,很具有代表性,虽然没有直接带来损失,或多或少也会给用户带来不好的安全体验。通过针对性的紧急修复,算是在这场攻守之战中,速战速决,可谓魔高一丈,道高一尽!

Case 1:接口中暴露了用户帐号信息,恶意用户扫描爬取帐号

有的时候,程序员写的接口会返回丰富的数据,有用的,没有用的,都带上。今天这个Case就是这种很常见的现象,带上了帐号信息,而实际上又没有使用到。导致有网友通过接口爬取信息,还将工具晒到了网上。

处理解决:

  1. 通过抓包分析工具wireshark分析被爬取的接口,大概有3个不同的URL,查代码对应到内部一个处理逻辑。
  2. 将返回结果过滤掉帐号信息再返回

事后点评:一段代码一段逻辑都有自己的生命周期,在早期的时候,更注重有没有,能不能满足基本的业务需求。随着业务的发展,考虑的问题越来越细致,有的不是问题的问题也就都出来了。也不能因此就提心吊胆的写代码,大概更新一下准则,有个可执行的标准即可。能防范于未然,那是更好不过。

Case 2:短信验证位数问题

有的时候想体验更亲民,短信验证码设置成4位数字,验证不卡次数,有效期一分钟。在这种验证逻辑下,暴力破解很容易就穷举完验证码,安全风险算是比较大。大多数平台选择6位数字验证码,也有别的平台字母加数字,选用7位的,8位的平台也有,不多!平安银行就是不走寻常路。短信验证码是一个很常见的功能,感觉设置成6位,卡一下验证次数会比较好。

今天最大的收获在于使用wireshark分析了http请求,又收获一个强大的工具。虽然用得不专业,但是对于这种简单的抓包分析,在工具上起到了非常重要的作用!

发表在 未分类 | 留下评论

技术岛Jishudao公众号开通啦!修炼技术就在技术岛!

技术岛公众号

技术岛公众号

技术岛Jishudao.com 修炼技术就上技术岛!无论是大神还是虾米,这里有踩坑干货,也有经验分享!技术岛的初忠在于以技术为沟通交流的桥梁,建立一个技术交流与分享的小平台!希望每位来到技术岛的小伙伴都能积极投递文章!技术岛服务公众号每个月推送4次,每次最多选10篇文章,对于选择标准,我们希望以经验分享为主,能结合一些实际的案例,分享一些经验性的东西。纯技术文档式的文章可能入选的小可能性小。当然,目前也是技术岛开设的初期,也没有一个固定的标准可以参考,希望投递过来的文章带有个人的态度与思考。

技术岛公众号是www.jishudao.com的官方公众号,也是通过一个新的媒体渠道传递技术正能量,每天工作或多或少都会有些收获,将自己所学,整理的过程也是一个自我成长的过程,希望更多的人能参与到技术岛的技术修炼环节中来。

技术岛福利待遇

对于在技术岛开通博客并积极投递文章的小伙伴,会有很多福利待遇哦!岛主将联合异业合作的小伙伴送出一波一波的福利!暴走小红包、免费零食、RMB打赏,只要文章写得好,技术岛将为您呈现满满的小福利!

技术岛公众号

技术岛公众号

发表在 未分类 | 留下评论

Storm Topology : Elasticsearch & Redis 构建实时性低延时数据统计分析 呈现大数据分析效果

写在前面

Storm实时分析系列文章已经有多篇了,每篇的重点不一样,今天的Storm文字直播分享的是Storm实时分析过程中的延时处理。在整理Storm 探针的过程中,发现Storm涉及的知识点还是很多的!最近所做的Storm工作都是基于Low Level API开发,而官方显示还有Tident高层次接口,数据落地方案也有不同的实现方案。在这里分享的是实战的心得,不一定是最佳的处理方案也不是实际落地方案,而是包含个人色彩的理解模型方案与实战方案的融合,仅供参考。

一天一收获

作为一个有态度的Storm经验分享者,先给大家介绍一下阅读完全文可以收获的知识点:

  1. ES落地优化经验
  2. 落地频率的取舍之道
  3. 实时数据呈现的Topology设计

业务背景

本大数据Storm业务背景是基于链路跟踪的日志分析处理,呈现出链接实时响应状态(正确率,调用关系,平均响应时长等等),链路跟踪的日志标记了同一请求的日志,同一请求日志有一样的跟踪标识,并且日志记录分收发时间。每个业务的请求调成关系图要实时计算出来。

日志特征

1.收发日志为2条日志,意味着时长计算需要将日志合二为一

2.链路跟踪为多条日志,意味着要从多条日志中生成调用关系

3.ES最初设计统计结果存储跨度为分钟,即每个接口的统计状态都是按分钟存储统计数据,每分钟的调用次数、总消耗时长

第一版 Topology

第一版Topology的处理满足了基本数据呈现指标,调用关系图生成、正确率、平均时长都能计算出来。美中不足之处在于,数据是合并到分钟存储,为了确保日志处理到分钟,设置了一定的时间窗口,等日志统计完再写到ES。时间窗口的设计导致查看到的数据存在延时。

实时性优化

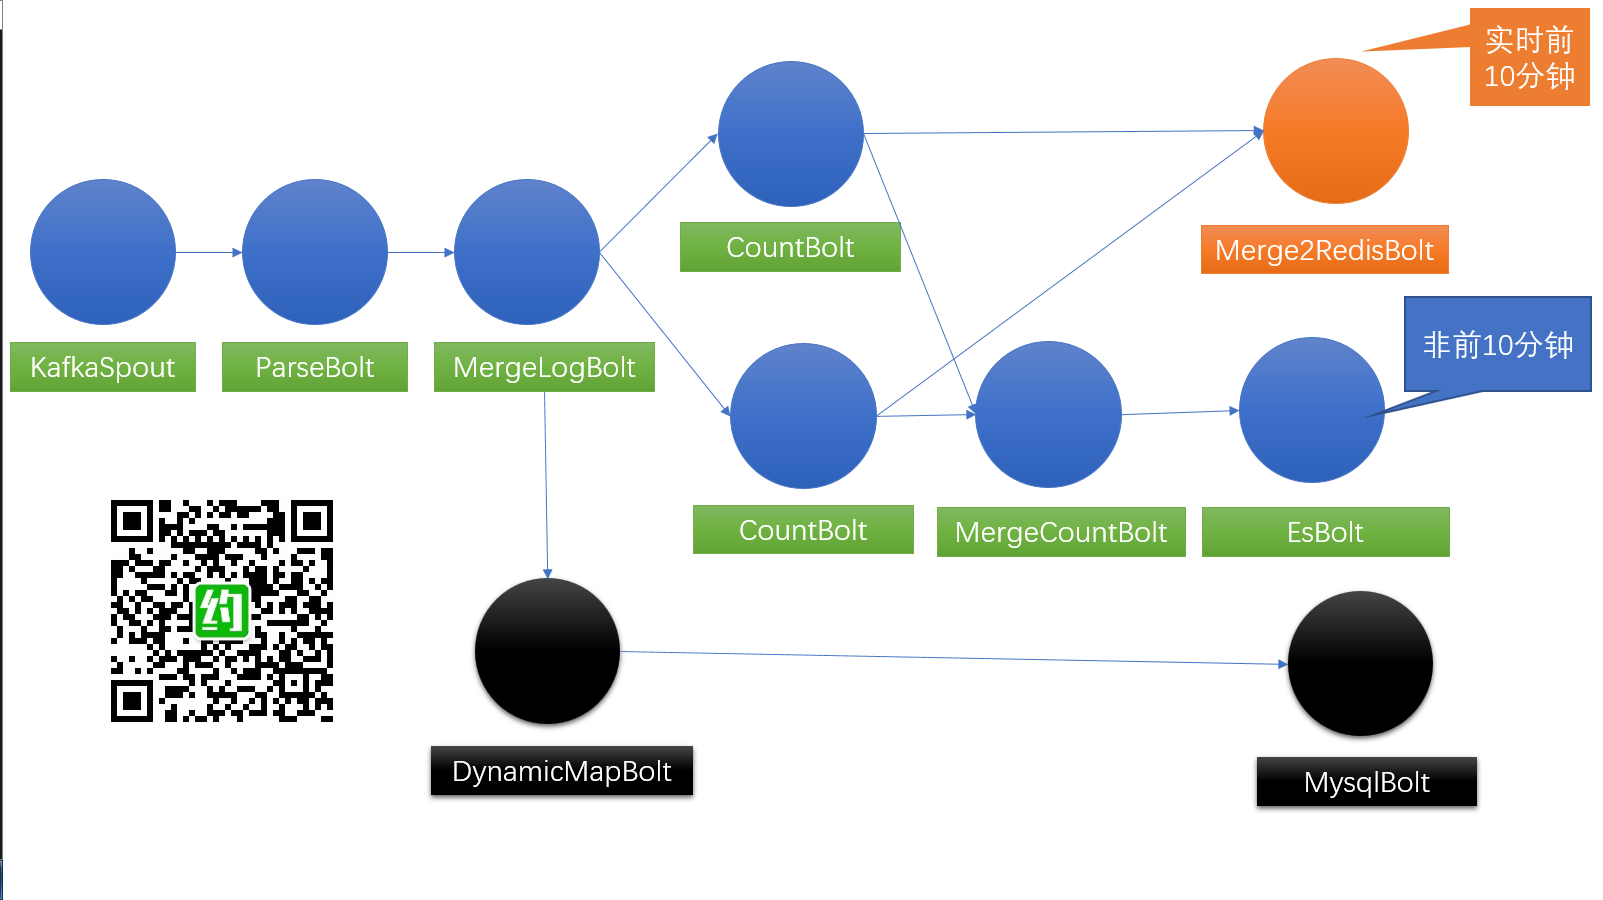
优化方案有两种,一是调整ES落地频率,提升实时性,同时改造查询接口,将每分钟的结果合并处理!二是借助Redis等内存解决方案,将查询结构分成内存区以及ES区。方案一相对更好实施,只需调整落地频率,并改查询接口做调整,方案二则需要引入新的内存解决方案。虽然没有选用方案二,但是个人还是更倾向于方案二。

ES采用批量插入模式,效率会更高,否则日志处理速度会很慢。实战经验显示,逐条插入几个小时,批量插入可能几分钟。

升级版 Topology 【Dream Version】

方案二利用了redis存储统计结果,落地ES的数据还是按分钟存储,不会像方案一,一分钟数据可能产生多条统计数据。从存储上、实时性上,方案二都更加完美。方案一的频率会影响ES存储量,所以采用方案一的话,落地频率是把双刃剑,得有所取舍。方案二则会更加灵活,不会增加ES存储负担。

The End

目前来讲,还没有在正式环境运行,我们也算是在吃Storm螃蟹,是否应用得当,也要更进一步的看运行效果。实时性的要求,也要看业务运用的情况。优化也是一个需要探索的事情,今天就先到这里。

预告

近期会推出

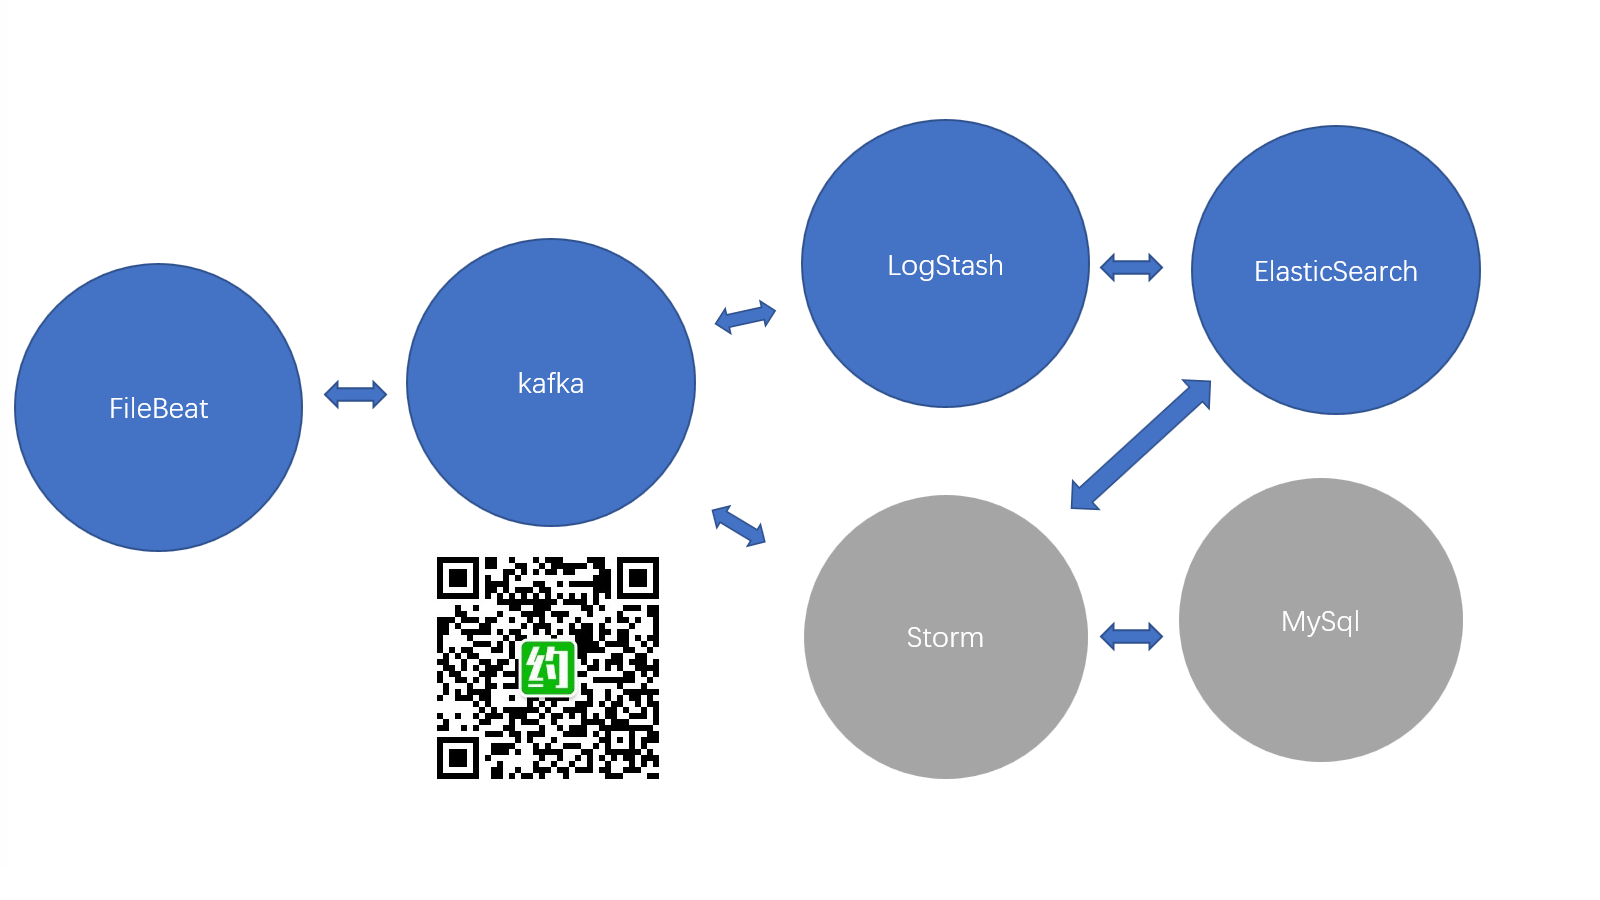
Docker+Linux+FileBeat+Kafka+LogStash+Elastic+Storm+MySql

系列部署实战文章,关注公众号,每天进步一点点。

巧妙拆分bolt提升Storm集群吞吐量

发表在 未分类 | 留下评论

Storm 1.2.2 Run Under Windows 7 : 试错填坑之路!大数据玩得是耐心与不放弃!开启干货模式纯享版

Storm实时大数据windows实验

Storm实时大数据windows实验

年前准备的大数据日志平台系统文章,缺少Storm环节,之前开发是在eclipse中直接跑的Storm,计划赶不上变化!Storm 1.2.2在Windows下跑得比较闹心。Storm 1.2.2 在windows 7下试玩,就是一个虐心之路,需要耐心需要一点一点排除问题。完整的看完本文,可以有如下收获:

  1. 能征服windows 7+Storm 1.2.2的配置
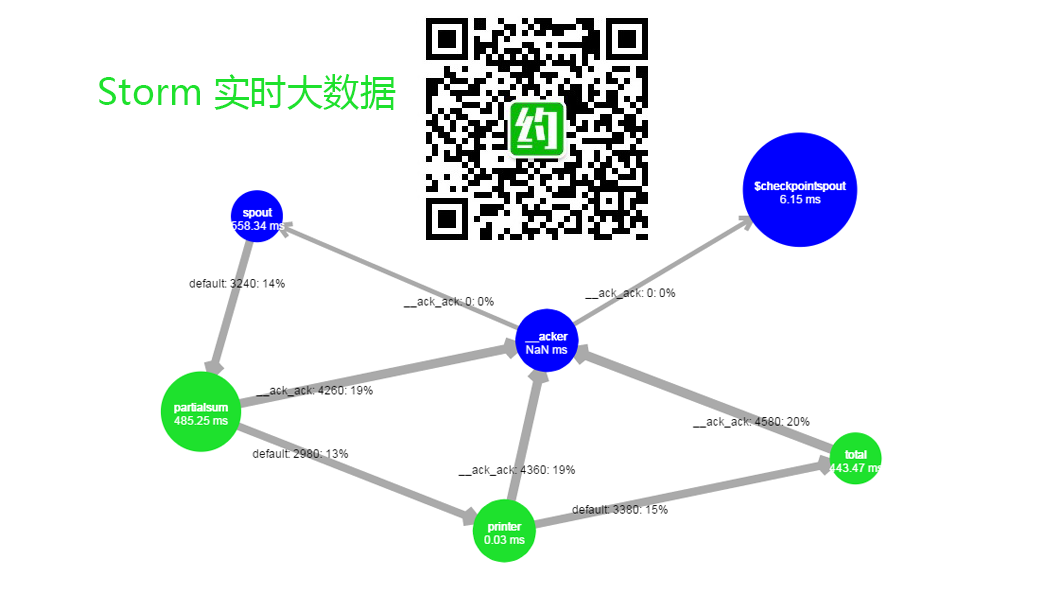
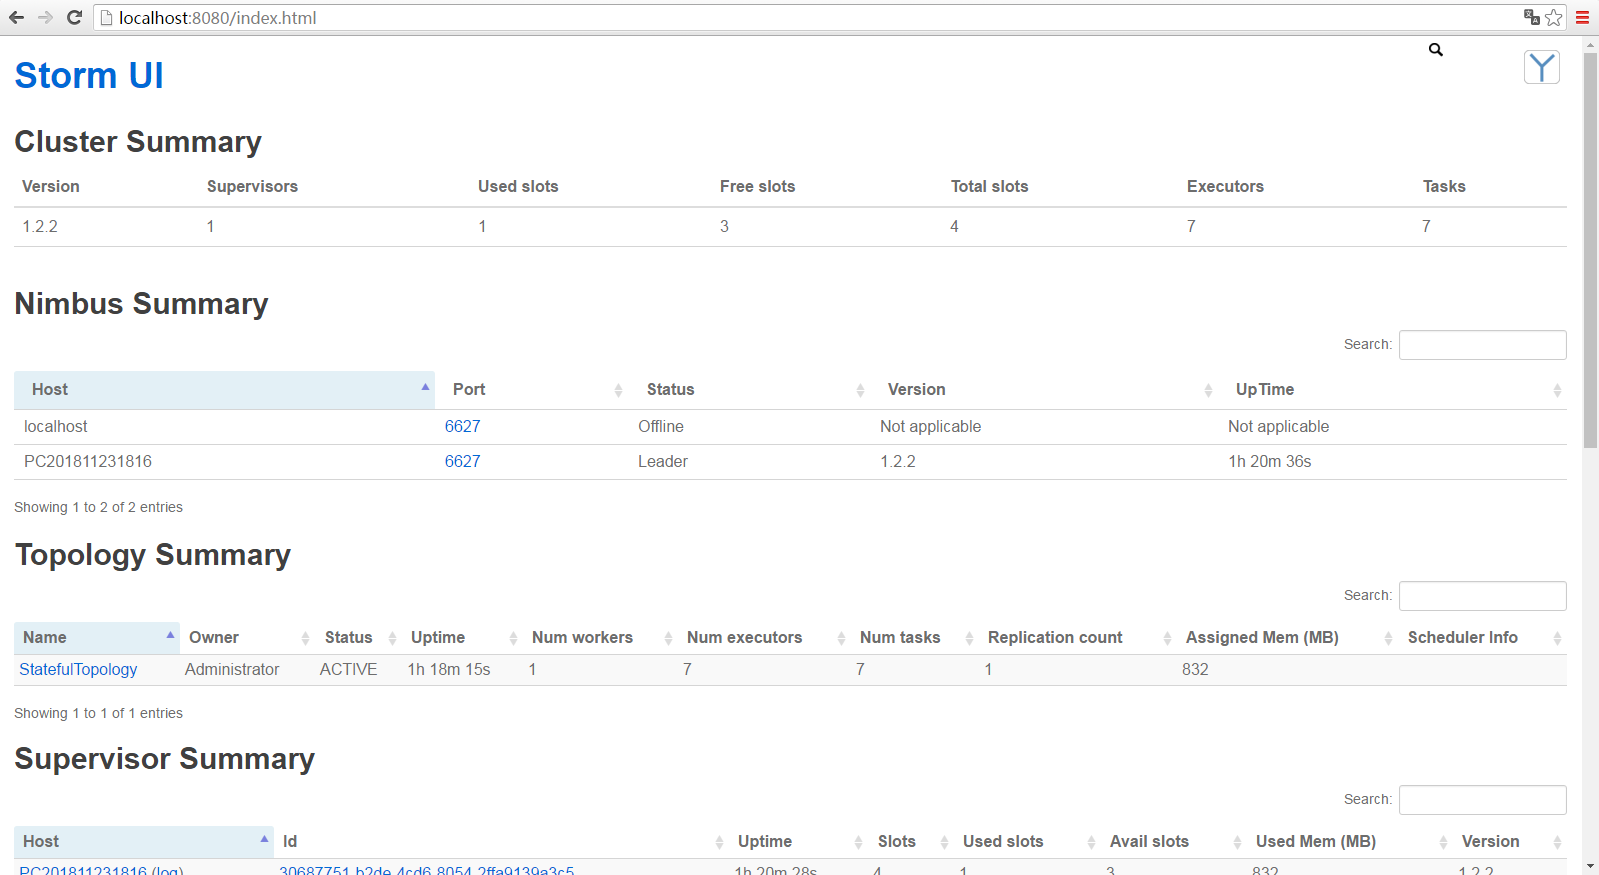
  2. 能跑起Storm Topology并查看拓扑的实时运行图,截取Storm Topology Visualization 图片,如本文封面。
  3. 收获跑storm1.2.2典型问题的三个文章链接,亲测好用,疗效显著

Docker+Linux部署大数据环境预告

年前的部署都是在windows下进行,后续将进行Docker+linux下的大数据环境配置实验,感兴趣的小伙伴可以关注本公众号。

写在前面

玩开源有一个需要重点注意的地方,不同的版本兼容性不一样,本次大数据实验是在windows 7 +storm 1.2.2 + zookeeper-3.4.12 的搭配下进行,其他环境下仅供参考。zookeeper-3.4.12部署与搭建请参考:

大型互联网平台日志系统(FileBeat+Kafka+LogStash+Elastic+Storm+MySql)小白的入门实战篇

总结如下:

一、cmd命令无法使用,跳过cmd命令,直接使用python命令

不要使用storm自带的storm.cmd,重要的事情再说一遍,直接使用storm.py去跑命令

storm.cmd提示被抛弃了,要使用storm.ps1,执行powsershel,提示问题:

$PSCommandPath为空,

Python Version 解析失败

修复方案一:$PSCommandPath为空,可升级为PowserShell 3.0 或者硬配置为当前路径

修复方案二:Python Version 使用PowerShell简单调试一下,可以修正为:

$PythonVersion = (& python -V 2>&1).ToString().Split(” “)[1];

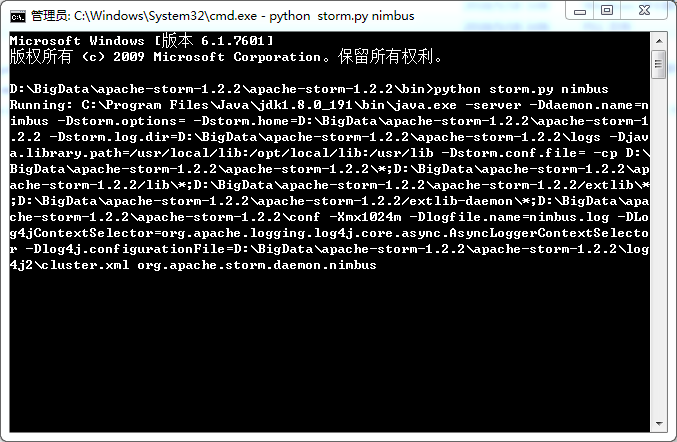
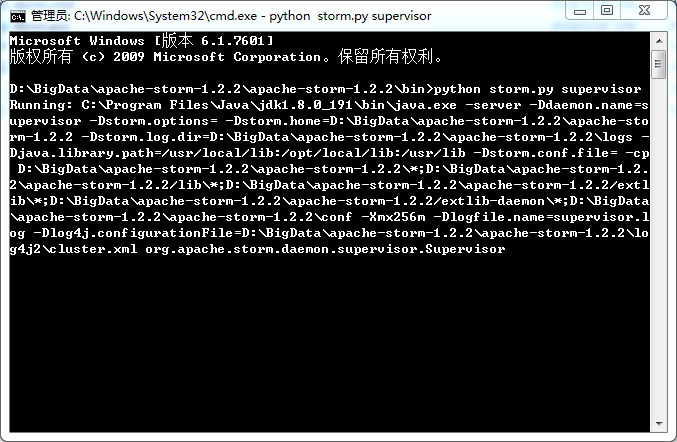
cmd\powershell都被我跳过了,cmd,powershell一顿如狼似虎的操作,最后也是调用python,再去调java,所以直接忽略cmd/powsershell,使用如下命令:

命令执行位置:

D:\BigData\apache-storm-1.2.2\apache-storm-1.2.2\bin

常用的几个命令:

python storm.py nimbus

python storm.py supervisor

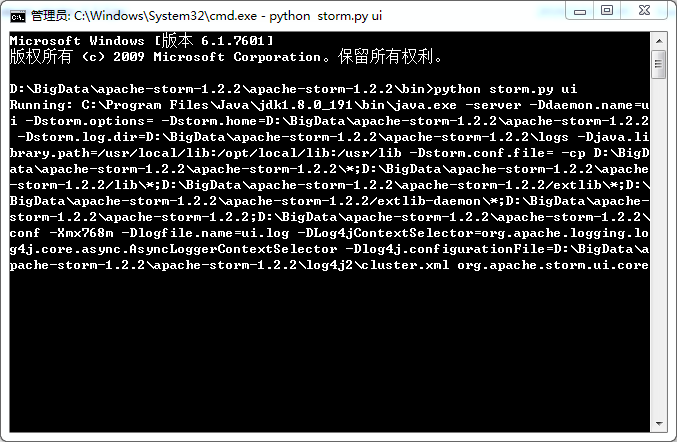
python storm.py ui

默认UI端口是8080

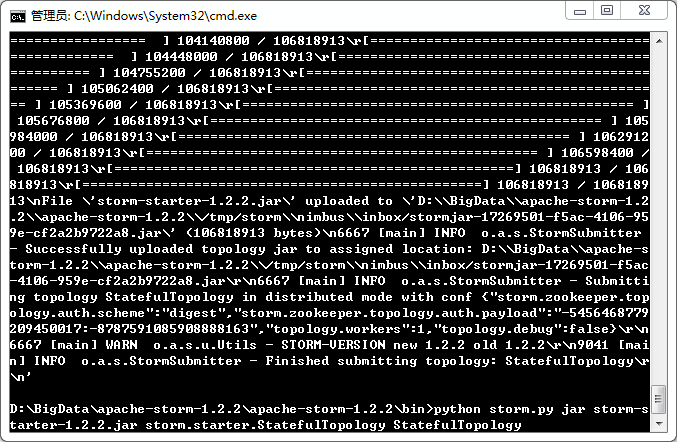
python storm.py jar [xxxx].jar [带命名空间的topology] [topology别名-可任性取名]

取个例子:

D:\BigData\apache-storm-1.2.2\apache-storm-1.2.2\bin>python storm.py jar storm-starter-1.2.2.jar storm.starter.StatefulTopology StatefulTopology

二、apache-storm-1.2.2.tar.gz自带Demo,编译不容易

apache-storm-1.2.2.tar.gz中自带了丰富的示例代码,因为太丰富了,所以问题也来了。

2.1 太多Demo,反而不利于starter

提示找不到kafka-avro-serializer-1.0.0.jar,maven中心库没有这个,需要另外配置存储库,而我只是一个starter,想快速的跑起storm,并不想kafka!

解决方案,配置maven存储库:

通常所在位置:

C:\Users\Administrator\.m2\settings.xml

修改mirrors节点

 <mirrorOf>*,!confluent</mirrorOf>

增加一个新的repository

<repository>

<id>confluent</id>

<url>http://packages.confluent.io/maven/</url>

</repository>

2.2 多种开发语言支持,drpc,Too Much Under A JAR For Starter.jar

编译完之后,这个新人启航的jar包有100多mb,其实我只想是跑个超级简单的demo来看一下效果。连踩2个坑,一个是多语言能力展示,用java包裹python代码,跑不起来,一个是用java包裹node.js,也没有跑成功。本想,一个一个问题kill掉,但是网上的套路都不管用。暂时先不管Storm的多语言支持。另一个是drpc服务,二次选择topology,踩到 drpc了,配置完drpc,还是不管用,再次跳过,目前也没有这个使用场景。最后,仔细的找了一个简单的,纯java血统的topology: StatefulTopology

三、其他问题

向 storm 提交 jar 包后,访问 http://localhost:8080/index.html 有时候能看到topology,但是没有节点跑。等了一会儿也没有。解决方案:将storm 中的topology kill掉, nimbus,supervisor,ui全部停了,重新提交一遍。大概在第三遍的时候出来了,懵逼的状态【可能哪一步做错了】~~截到图:

Storm实时大数据windows实验

Storm实时大数据windows实验

2.3 又见PowerShell

storm.ps1的错误提示,真心不够友好!为了检测python版本是否符合要求,写了好几行ps代码,结合ps代码本身也有版本要求。

$PSCommandPath 为空,代码直接报错

这段ps1 ,应该有提示ps版本问题。

或者,应该是有一个前置安装检查的脚本或工具,引导玩家或自动处理前置安装问题,这样子才会更加好友。这个方面微微软的sqlserver安装向导就做得比较好~

PowerShell 未经数字签名 系统将不执行该脚本

set-executionpolicy Bypass

写在后面

python storm nimbus这种命令方式是同事告诉我的,不然还在坑里爬。本来windows 7 + Storm就是非常规的组合,只是想把windows系列的文章写全了,跑通,所以才挣扎了这么久。感觉从事开源,就像一个自己的舞台,大家很努力的做一个storm,别人用得是那么的闹心,虽然官方提供了那么多文档那么多示例。storm.cmd , storm.ps1的提示真心留下了阴影。期待下一波Docker+linux玩转大数据吧,同样是zookeeper,filebeat,kafka,storm,elasticsearch等,一步一步亲测,全部跑通!

巧妙拆分bolt提升Storm集群吞吐量

参考链接:

找不到kafka-avro-serializer-1.0.0.jar

https://stackoverflow.com/questions/43488853/confluent-maven-repository-not-working

PowerShell版本问题

https://stackoverflow.com/questions/24663243/why-doesnt-write-host-pscommandpath-output-my-current-path

发表在 未分类 | 留下评论

大型互联网平台日志系统(FileBeat+Kafka+LogStash+Elastic+Storm+MySql)小白的入门实战篇

大型互联网平台日志系统(FileBeat+Kafka+LogStash+Elastic+Storm+MySql)小白从入门实战篇

大型互联网平台日志系统(FileBeat+Kafka+LogStash+Elastic+Storm+MySql)小白从入门实战篇

原计划昨天的公众号图文直播因公司年会抽奖而没有进行,今天在自己的电脑上实战了FileBeat+Kafka+LogStash+Elastic+Storm+MySql的环境搭建,由于今天的实验过程并不顺利,所以整体实验方案砍掉了Storm、MySql,这将是明天的套餐。

作为一个有态度的资深公众号运营人员,写一篇文章不仅会为了达到原创标准凑够300字,同时也会把本次实战的心得与经验放到前面,让小伙伴能以最快的速度收获一些经验性的东西。同时,实战是一步一步操作,并跑并跑起来,是在坑里爬了很久,才写出来的,如果你有兴趣可以照着做一篇,是可以跑起来。看不明白的,可以留言问,包教包会~

完整的读完本实验总结,可以有以下收获:

  1. 能搭建互联网平台日志收集系统
  2. 能知道如何处理开源产品配置报错

本次实战的小心得如下:

  1. 玩开源产品,版本多,不要怕提示出错,网上多找找,一般都能找到答案。
  2. 这不是在堆代码,只是使用开源的产品,不需要编程功力。
  3. 先了解一下相关产品的设计思路,用得思路会更好些

本次实验用到的开源产品:

elasticsearch-6.5.4

elasticsearch-head

filebeat-6.5.4-windows-x86_64

kafka_2.12-2.1.0

logstash-6.6.0

zookeeper-3.4.12

autovisit.bat ( 这个一小段脚本,用来不断访问页面,以产生访问日志,自己DIY也可以,很简单。加头我放到Github上吸粉

本次实现新增加了Kafka\LogStash\zookeeper,先来看一下实现录的小视频,直观的感受一波操作。

关注公众号 Yuema约吗 可以查看录制的视频

一、zookeeper

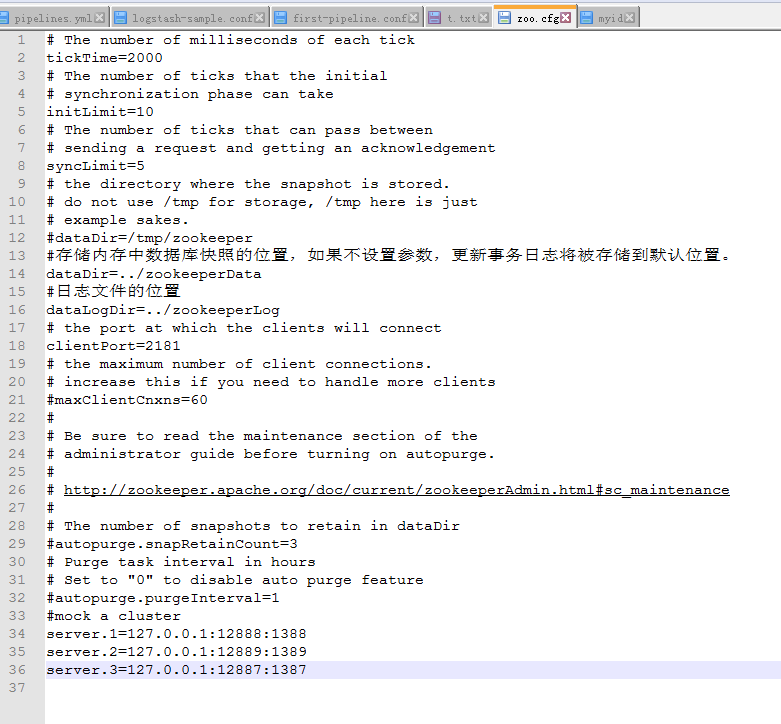
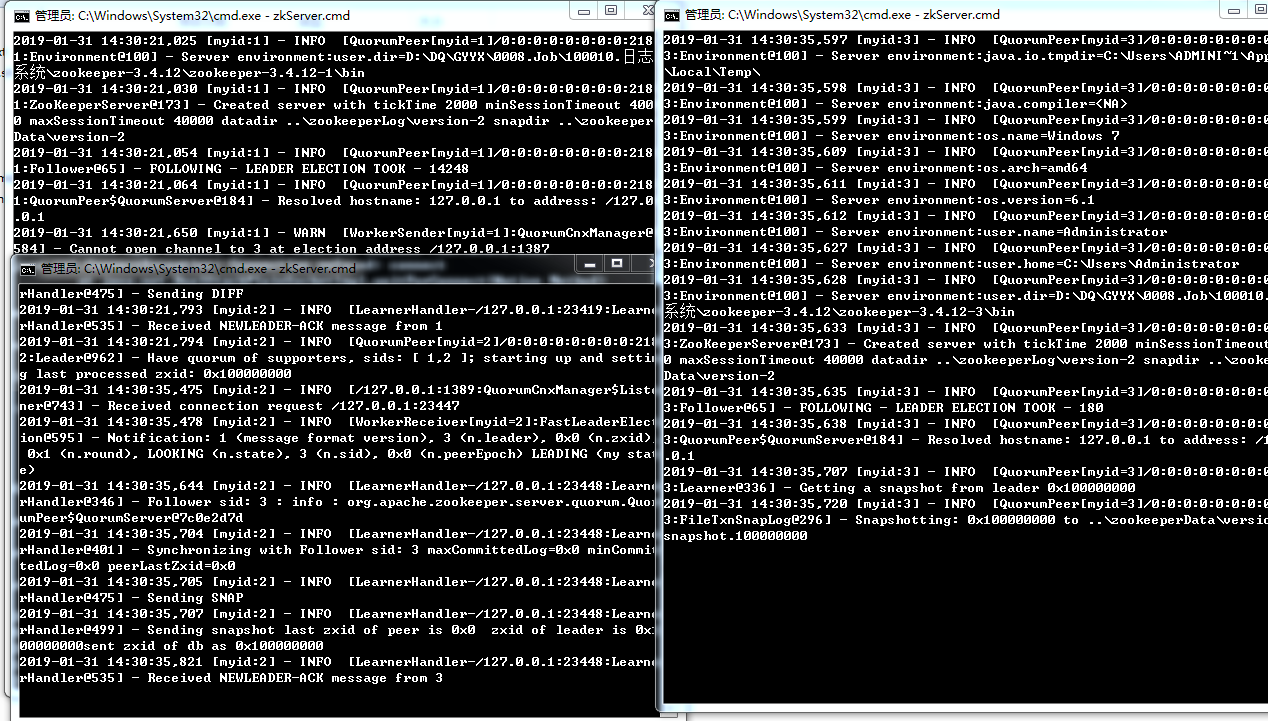
kafka用zookeeper来协调集群节点,apache下很多开源产品都是用zookeeper来协调集群节点。知道这么回事就好。本次实战就不讲原理了,感兴趣的小伙伴可以去查资料。跑命令 zkServer.cmd 启动!配置文件:zookeeper-3.4.12\zookeeper-3.4.12-1\conf\zoo.cfg [把zoo_sample.cfg修改成zoo.cfg],用单机模拟的集群,所以后面有带了三个节点配置。纯体验的话,可以去掉,直接跑单机,看到的效果是一样的。

zookeeper_config

zookeeper_config

#存储内存中数据库快照的位置,如果不设置参数,更新事务日志将被存储到默认位置。

dataDir=../zookeeperData

#日志文件的位置

dataLogDir=../zookeeperLog

#mock a cluster

server.1=127.0.0.1:12888:1388

server.2=127.0.0.1:12889:1389

server.3=127.0.0.1:12887:1387

zookeeper_three_node

zookeeper_three_node

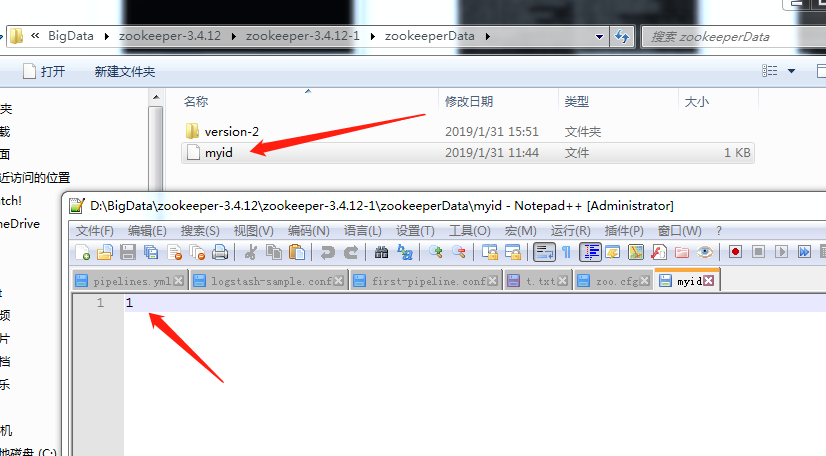
偏好配置还需要zookeeper-3.4.12\zookeeper-3.4.12-1\zookeeperData中加一个无扩展名的myid,三个节点可分别取值为1,2,3

zookeeper_three_node_file

zookeeper_three_node_file

zookeeper_three_node_file_myid

zookeeper_three_node_file_myid

二、Kafka

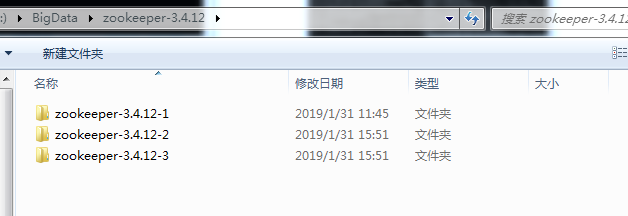
三个节点,把文件压解出来,先配置好一个,再复制几个,再微调一下。结构如下。因为是单机模拟集群,所以就这么干啦。

打开配置kafka_2.12-2.1.0\kafka_2.12-2.1.0-2\config\server.properties

重点配置敲黑板,注意,单机三个节点的话,端口改成9092,9093,9094,日志文件如果像我一样傻傻的用绝对路径的话,一定要每个点节都加上自己的编号区分开,不然会一直报错!

关键配置

listeners=PLAINTEXT://:9093

log.dirs=/tmp/kafka-logs-2

启动kafka

kafka-server-start.bat ../../config/server.properties

注意:这里用的是相对路径,跑LogStash的时候也要这么干,网上找到一个教程没有这么干,一直报错

相关命令送上来:

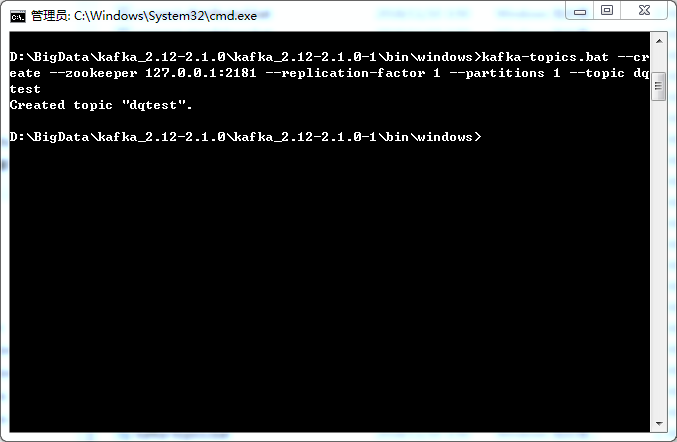
创建主题

kafka-topics.bat –create –zookeeper 127.0.0.1:2181 –replication-factor 1 –partitions 1 –topic dqtest

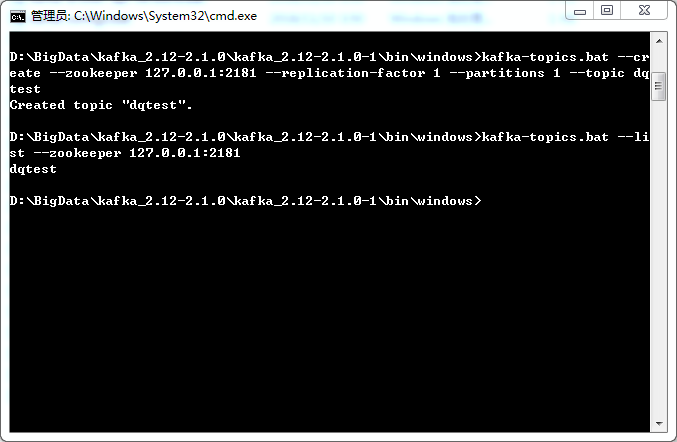
罗列kafka主题

kafka-topics.bat –list –zookeeper 127.0.0.1:2181

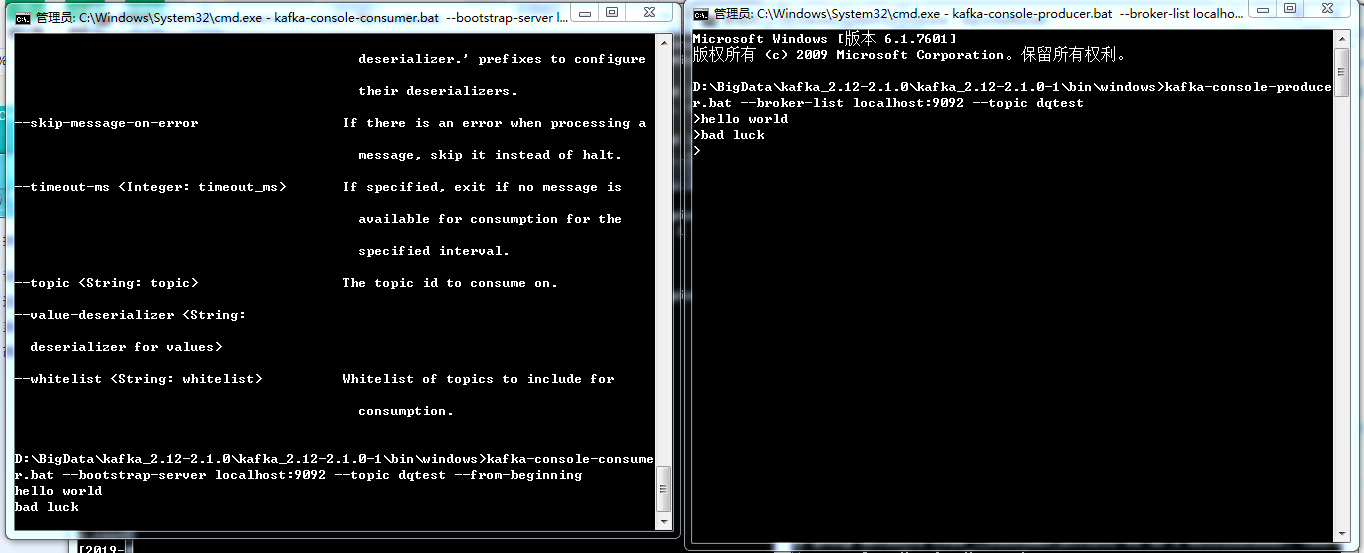
消费topic

kafka-console-consumer.bat –bootstrap-server localhost:9092 –topic dqtest –from-beginning

敲黑板:不同的版本命令有所差异,如果跑不起来,可以核对一下版本对不对。同时,除了搜索,还可以打开config中的文件配置,查看睦一下到底是用的bootstrap-server还是zookeeper,嗯~就是这样子,算是很容易掉坑里的环节。

生产topic消息

kafka-console-producer.bat –broker-list localhost:9092 –topic dqtest

三 LogStash

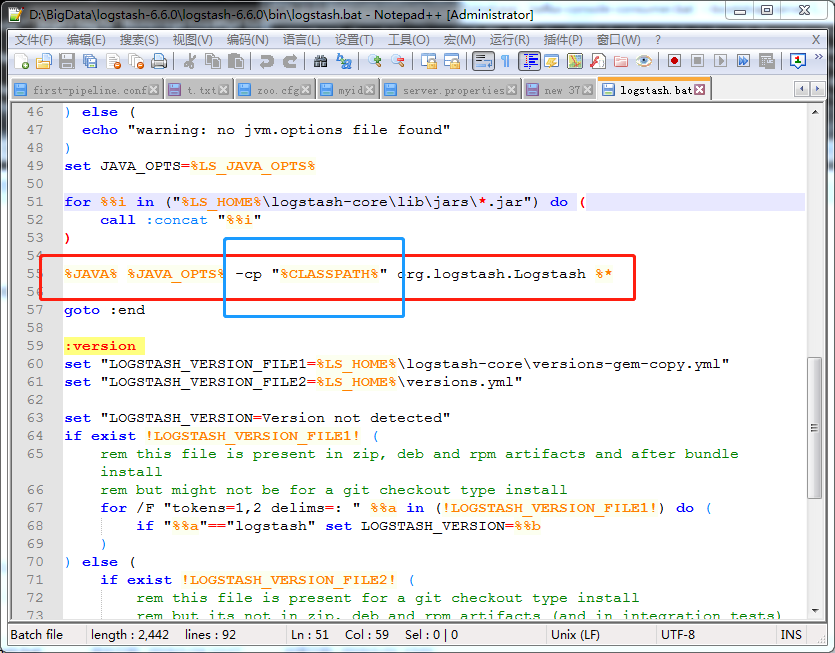
3.1 填坑之路:报错找不到主类

解决:logstash-6.6.0\logstash-6.6.0\bin\logstash.bat

将55行的  %CLASSPATH% 修改 “%CLASSPATH%”

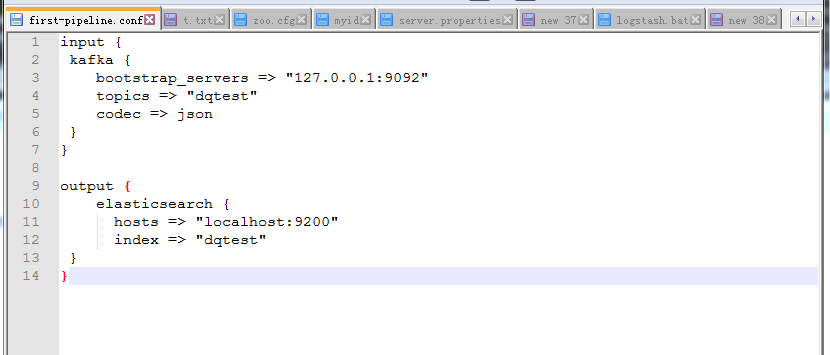
3. 启动命令

logstash -f ../config/first-pipeline.conf –config.reload.automatic

因为找到的资料用的是first-pipeline,所以也跟着敲了,唯一要注意的是,这里记得加上../config/,不然找不到配置文件的。

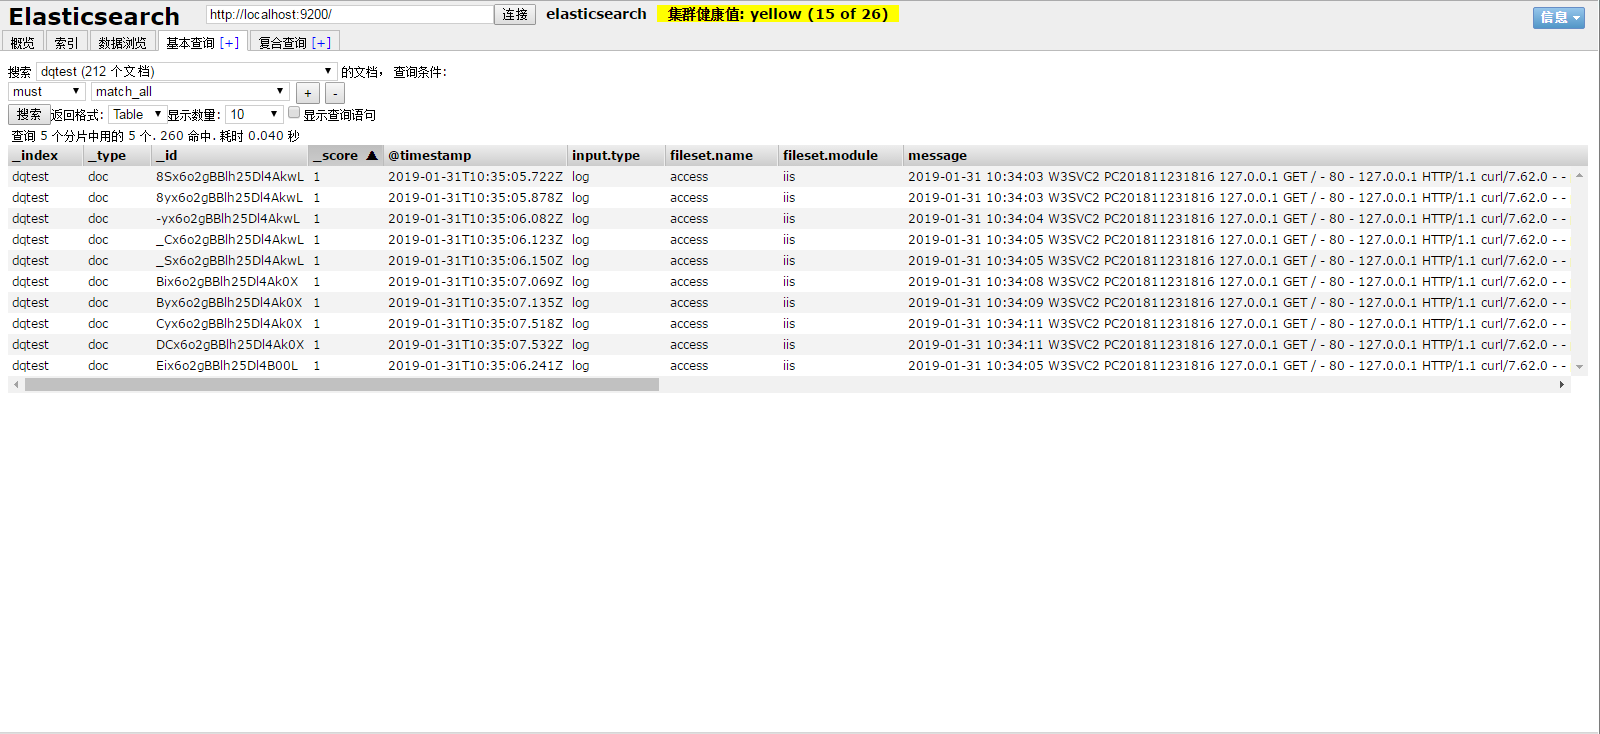
见证奇迹的时刻来了,折腾大半天,最后将FileBeat->Kafka->LogStash->Elasticsearch配通了,结果会是什么样子的呢?

哈哈,就是这样子的啦~今天的实战说真的不太顺利,遇到的小坑都有点意外,其中还需到报路径太长,之前是D:\DQ\xxxx\0008.Job\100010.日志系统\filebeat-6.5.4-windows-x86_64,报错后,修改成了D:\BigData\filebeat-6.5.4-windows-x86_64

明天的大餐是将Storm+MySql配置进来,Storm从Kafka消费数据,将运算结算存到mysql,关注公众号就能收看明天的大型实时日志系统实验总结!期待明天相聚在约吗图文直播间。

巧妙拆分bolt提升Storm集群吞吐量

发表在 未分类 | 留下评论

FileBeat+ElasticSearch+Kibana 实时日志系统搭建从入门到放弃 小白玩大数据日志分析系统经典入门实操篇


大数据实时日志系统搭建

大数据实时日志系统搭建

距离全链路跟踪分析系统第二个迭代已经有一小阵子了,由于在项目中主要在写ES查询\Storm Bolt逻辑,都没有去搭建实时日志分析系统,全链路跟踪分析系统采用的开源产品组合为FileBeat、Kafka、LogStash、Elastic、Storm,外加自主前端、自定义日志。今天挤出时间,选用FileBeat、ElasticSearch、Kibana搭建了一个实时日志系统。搭建之前,看了一下Elastic Stack产品组织中的LogStash,一般建议FileBeat输出到LogStash,再由LogStash到ElasticSearch,今天的实操并没有使用到kafka、LogStash、Storm,这是明天的主餐,感兴趣的可以关注公众号,明天接着看。

看完本篇文章,您可以有以下收获:

a)您能够搭建一个实时的日志分析系统,并能知道如何处理遇到的问题。

b)您将了解Elastic+Kibana在日志分析、商业大屏、航空看板、商业分析的应用,并能结合自身公司的业务情况,有选择的为公司实施大数据,提升公司的数据价值挖掘能力。

c)看不懂,包教包会

作为一篇有态度的技术文章,先把本次实操感受写在前面。

一、ElasticSearch-head揪心之作

1.1 揪心之作

部署完ElasticSearch,没有UI界面,这跟很多开源产品的现状很像,apache出品的不少开源产品,好多UI也是丑丑的。elasticsearch-head作为ElasticSearch UI的空白,算是一个惊喜,在Github上获得了5000多个星星,梦想中的星星数量啊。揪心的是,用起来,就是有点不爽啊,滚动条拖到尾部才能找到,也是丑丑的~复杂查询也是不够好用~

1.2 部署经验

npm install跑不成功,yarn install成功跑起来。最好将源改为国内大厂源,不然,应该是直接失败吧。

1.3 开源收获粉丝还是存在很多机会

ElasticSearch-head弥补了ElasticSearch UI确实,还有优化空间。kibana也有完善空间。

二、安全问题也许就是网上教程传出来的

ElasticSearch默认不允许跨域,网上查到的解决处理是

http.cors.enabled: true

http.cors.allow-origin: “*”

对于正式使用的话,还是有些风险的。自己玩弄着完是可以,真正使用的话,要限定一下。这招防君子不防小人。

三、完美的不可用产品kibana

这么说可能会引起kibana粉丝的不爽,对于一个全链路跟踪系统来讲,kibana真的是满足不了,kibana有着非常漂亮的UI,灵活的可视化呈现,却无法适应我们的业务场景,或者说,就着kibana的话,会付出更多的二次开发成本。kibana有着丰富的可视化组件,却没有我们所需的调用图。全链路跟踪分析系统没有使用kibana,而是自主研发的前端。

kibana有对于现有产品IIS\Apache\Mysql\服务器等等,都有数据采集组件,可以对系统所采用的软件进行监控。对于特定的业务,需要二次开发,比较复杂的业务的话,需要在kibana基础上进行二次开发,会比较麻烦。

四、FileBeat只是Beat产品中的一个

今天看资料才发现,Beat产品组中还有很多,FileBeat只是其中一个,目前完整组合是Filebeat,Metricbeat,Packetbeat,Winlogbeat,Auditbeat,Heartbeat,Functionbeat!全方位收集日志,监控无所不及。我们只用FileBeat~

五、跑开源产品不要怕报错

虽然会吓一跳,但是仔细看提示,还是能看到错误提示中给出的解决办法。

5-1. 跑FileBeat收集IIS Log时,会发现,ElasticSearch中查到的结果显示正则解析失败!

因为默认的grok规则配置是记录所有IIS字段,而IIS默认的log没有输入所有的字段,打造IIS站点日志配置,将其他没有输出的字段都勾选上。

尴尬:grok的正则写法丢到Match Tracer(一个正则调试工具)中,直接懵圈了,放一条日志进去匹配不到。字段对不上。

配置现场:

filebeat-6.5.4-windows-x86_64\module\iis\access\ingest\default.json

除了iis module,还有很多丰富的module备选,apache2,auditd,elasticsearch,haproxy,icinga,iis,kafka,kibana,logstash,mongodb,mysql,nginx,osquery,postgresql,redis,suricata,system,traefik

5-2.使用IIS module,要开启相应的插件

不要慌,报错上面有提示,跑2条命令。玩开源啊,要有看报错的准备,从报错中看答案。看不出来再去搜索~

六、where is Ambari

Apache Ambari能傻瓜式的部署安装Hadoop,Elastic系列产品少了一个类似的产品。对于开源届来讲,不了一个统一的傻瓜式部署平台。如果有的话,请留言告诉我哈~

七、where is  智能调优

一堆产品组合成一个解决方案,人肉调优好心碎,也不专业。

八、 Kibana机器学习初感

初看,是看不出什么内涵,就罗列了一堆维度,看不出什么机器学习的能力。好像一个营销噱头,也可能我没有看到kibana的机器学习功力。

能坚持看完吐槽的小伙伴,真的是铁丝。接下来会将本次实验的步骤截图展示出来。很多都是网上可以查到的!也不要太失望,我截了不少效果图,对于不想动手搭建环境的老铁,可以直接看效果图,再决定要不要玩起来。

部署说明,本次搭建的实时日志分析系统用到了FileBeat,ElasticSearch,Kibana,都可以从官方网站www.elastic.co直接下载。elasticsearch-head请从github上下载。基本上都是开箱即用的,只有少部分要调整,依据我的部署说明来,应该能通关,如有遇到解决不了的问题,也要可以在公众号中留言提问,我会解救你。

部署步骤:

前置:安装jdk,我用的1.8版本,自行安装解决。

  1. 安装elasticsearch-6.5.4
  2. elasticsearch-head
  3. kibana-6.5.4-windows-x86_64
  4. filebeat-6.5.4-windows-x86_64

不要怕,都是解压出来就能跑
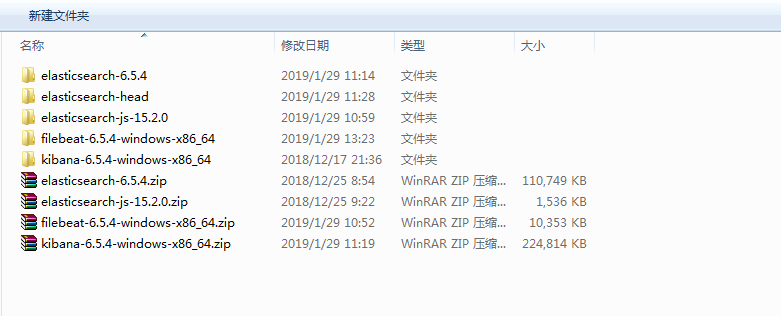
大数据实时日志系统搭建文件目录

大数据实时日志系统搭建文件目录

1.安装elasticsearch-6.5.4

解压出来,跑 elasticsearch-6.5.4\bin\elasticsearch.bat

跑完,可以查看localhost:9200,能查看到类似以下界面!纯接口,人类表示无法看,于是要安装一个elasticsearch-head,类似一个管理查看的。
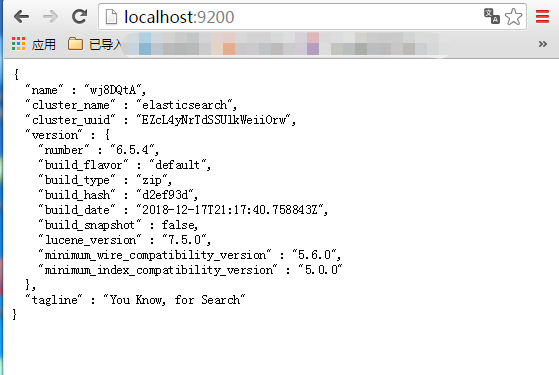
elasticsearch_9200安装成功效果图

elasticsearch_9200安装成功效果图

2.安装elasticsearch-head

将https://github.com/mobz/elasticsearch-head

克隆或者下载到本店,下载一个node.js,安装好

因为这个东东需要用到node.直接到node.js上下载一个,一路next,就安装好了node.js。

cmd进入到elasticsearch-head的目录

依次输入

yarn install

yarn start

命令说明:yarn install是恢复elasticsearch-head引用到的包,yarn start是用于启动。当然,也可以使用npm install,npm start,最终效果是一样的,如果你没有安装yarn的话,可以用npm。因为资源可能在国外,所以执行命令会慢,等一等,如果失败的话,请更换成国内的源。(可以搜索,也可以来问我哈)

见证奇迹的时刻来了:
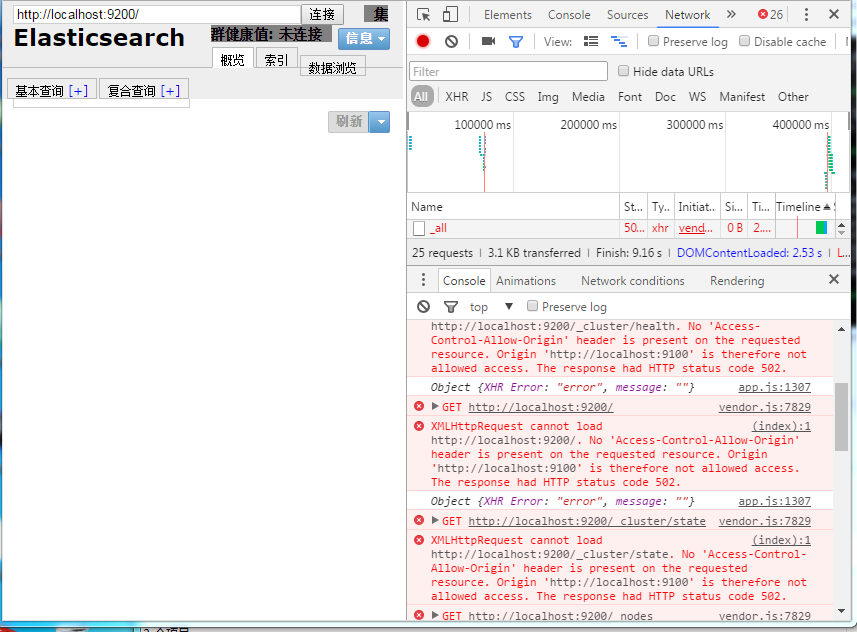
elastic-header-cors_problem

elastic-header-cors_problem

报错了,提示跨域了。解决方案:修改elasticsearch-6.5.4\config\elasticsearch.yml,增加:

http.cors.enabled: true

http.cors.allow-origin: “*”

备注:这里用的是*,如果用于生产环境,建议写具体的URI

处理完的效果图
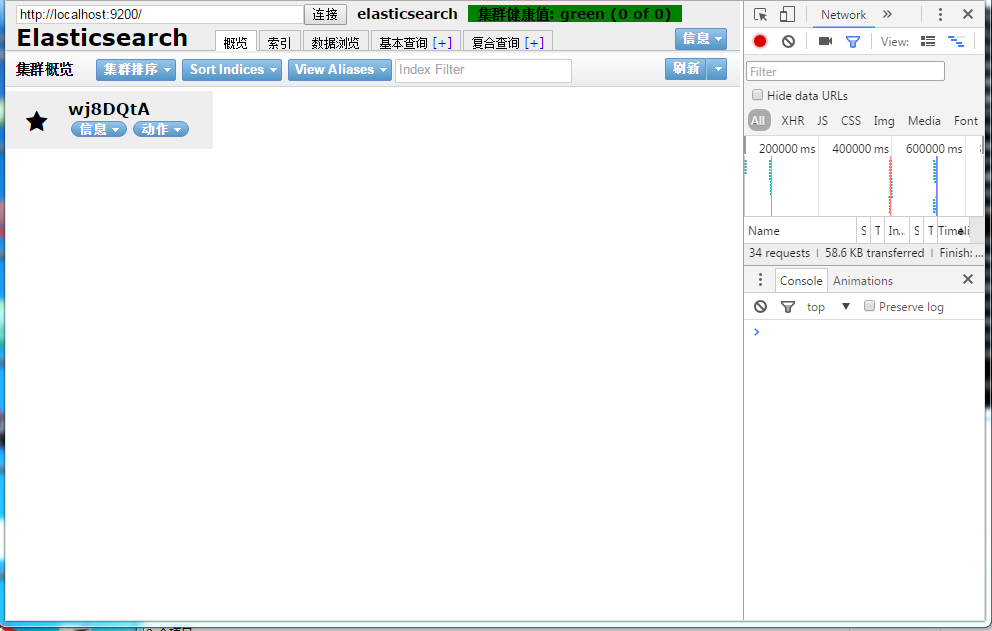
elastic-header-cors_ok

elastic-header-cors_ok

3.安装kibana-6.5.4-windows-x86_64

解压后执行命令  kibana-6.5.4-windows-x86_64\bin\kibana.bat

进入http://localhost:5601/ 查看kibana,进入是空白的,kibana自带了一些示例数据,在里面点点点就找到了,进入Dashboards

  • eCommerce
  • Logs
  • Flights

官方示例数据是三大领域,商业、日志、航班,覆盖了多数场景,可以照着官方的示例完成自身的业务需求。

4.filebeat-6.5.4-windows-x86_64

Filebeat收集IIS有点小插曲,不碍事。

将filebeat-6.5.4-windows-x86_64\modules.d\iis.yml.disabled 改名为 iis.yml

跑不起来,但是有提示。就像问道游戏,每个任务都会有明确的提示,不会晕菜。

小插曲来了,elaticsearch中的抓到的日志,message中显示解析失败,日志没有按一个一个字段存下来,而是一整条,看起来怪怪的。怎么破?

到IIS中,选择站点,右则会有日志,点开,选择字段,全部选上。

配置完,就能正确收到IIS日志信息了。

这就是我选这个图当封面的原因,坑啊。

怎么不断产生访问日志?

写一个.bat文件,多点开几个,跑着就好了。

:S

echo hello world

curl http://www.yue.ma

goto S

效果图

安装部署流程讲完了,不懂的地方可以随时留言!喜欢看效果图的小伙伴有福了,我截了不少kibana的效果图,一起来看看吧!效果图后面,还会分析一下,为什么kibana效果也不差,而且还是开源的,我们为什么不用kibanan

Kibana用来全方位监控服务器、数据库、网络状态、商业数据等等都是不错的选择,但是我们的全链路跟踪分析系统需求有些特殊,需要对各站点日志请求进行分析,归到不同的业务上,并依据日志生成调用关系图。这就是实时日志系统搭建从入门到放弃的来源,因为明天会升级方案!

明天将介绍FileBeat+Kafka+LogStash+ElasticSearch+Storm,全链路分析系统的大数据日志环境搭建!敬请关注明天的大数据日志分析实战图文直播!

发表在 未分类 | 留下评论

微服务 vs NeuronStorm 一次微服务的实战真实感悟 简化通道化身为神经元玩法 减少微服务中通道代码占比 节省代码时长

最近在微服务的工程下面增加业务功能,设计涉及三个业务领域,也就是微服务的堆栈要处理多个工程代码,类似于【通道代码】,本身并不是业务代码,占的比例还不少!构想一个NeuronStorm,由平台完成通道的管理与维护,消灭通道代码,同时可视化编程

最近在微服务的工程下面增加业务功能,设计涉及三个业务领域,也就是微服务的堆栈要处理多个工程代码,类似于【通道代码】,本身并不是业务代码,占的比例还不少!构想一个NeuronStorm,由平台完成通道的管理与维护,消灭通道代码,同时可视化编程

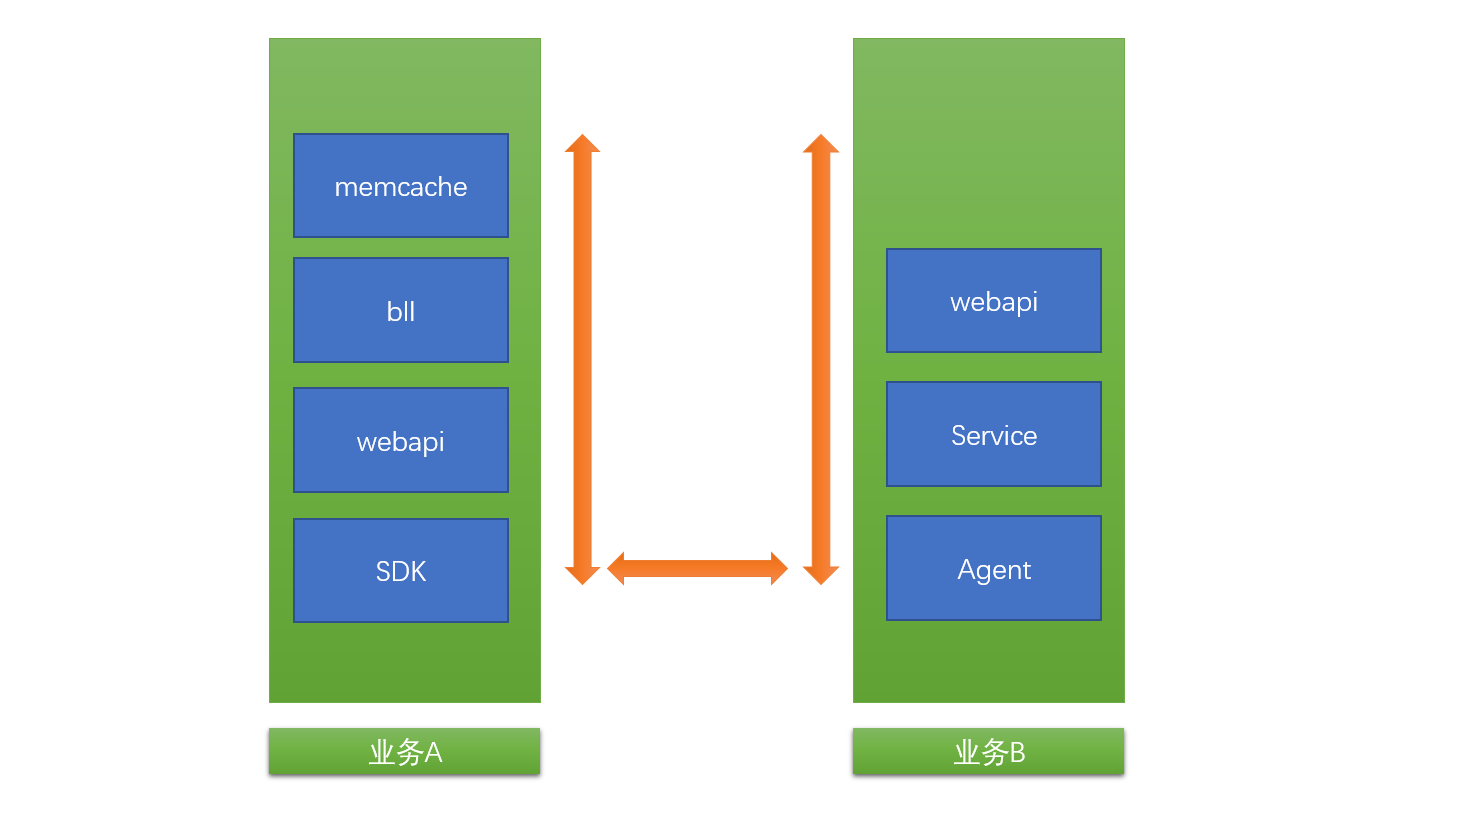
最近在微服务的工程下面增加业务功能,设计涉及三个业务领域,也就是微服务的堆栈要处理webapi<—>Service<—->Agent<—>SDK<—->webapi<—–>bll<—->memcache,建立微服务通道花了一些时间,占了一定比例的开发时间与代码工作,而真正业务代码量是比较少。

微服务的堆栈要处理webapi<--->Service<---->Agent<--->SDK<---->webapi<----->bll<---->memcache,涉及多个工程

微服务的堆栈要处理webapi<—>Service<—->Agent<—>SDK<—->webapi<—–>bll<—->memcache,涉及多个工程

微服务中通道代码能否做一些处理,以节省没有必要的时间占用呢?这是开发过程中一直在思考的问题。我想有以下两方面可以考虑:

  1. 代码生成器,对于微服务中各工程的代码,通道代码可以抽成模板或通过架构手段变成可生成的。当然这种玩法并没有改变微服务在通道代码上面的冗余。这种方案相对比较保守。但是对于现有工程来讲,不涉及大的变化,是比较好实施的。
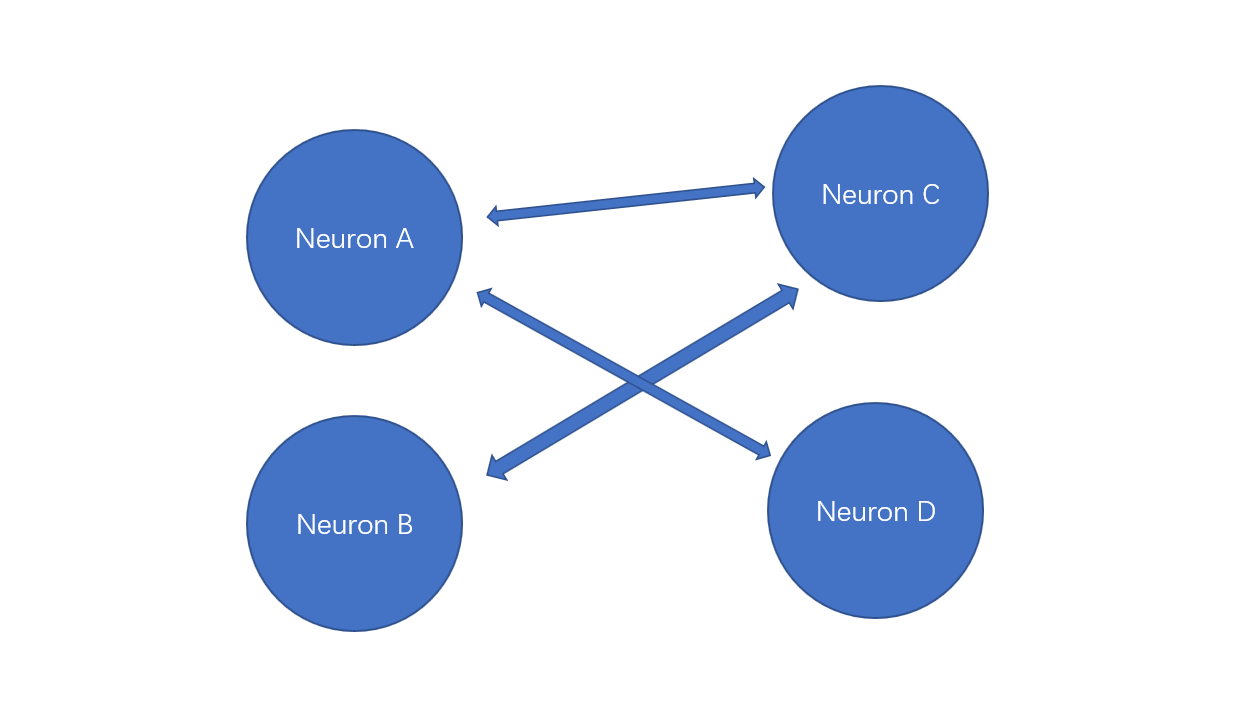
  2. NeuronStorm,这种方案的话,是将代码逻辑封装到一个处理单元中,Neuron并不用关心自己在哪个业务领域处理哪个机器上。由NeuronStorm统一调度,由业务人员自行配置。这种方案下,Cell之间的通道是基于NeuronStorm统一实现,所以将微服务中的通道代码全部消灭掉了。
NueronStorm中的Nueron单元共享NeuronStorm通道机制,省掉通道代码工作量

NueronStorm中的Nueron单元共享NeuronStorm通道机制,省掉通道代码工作量

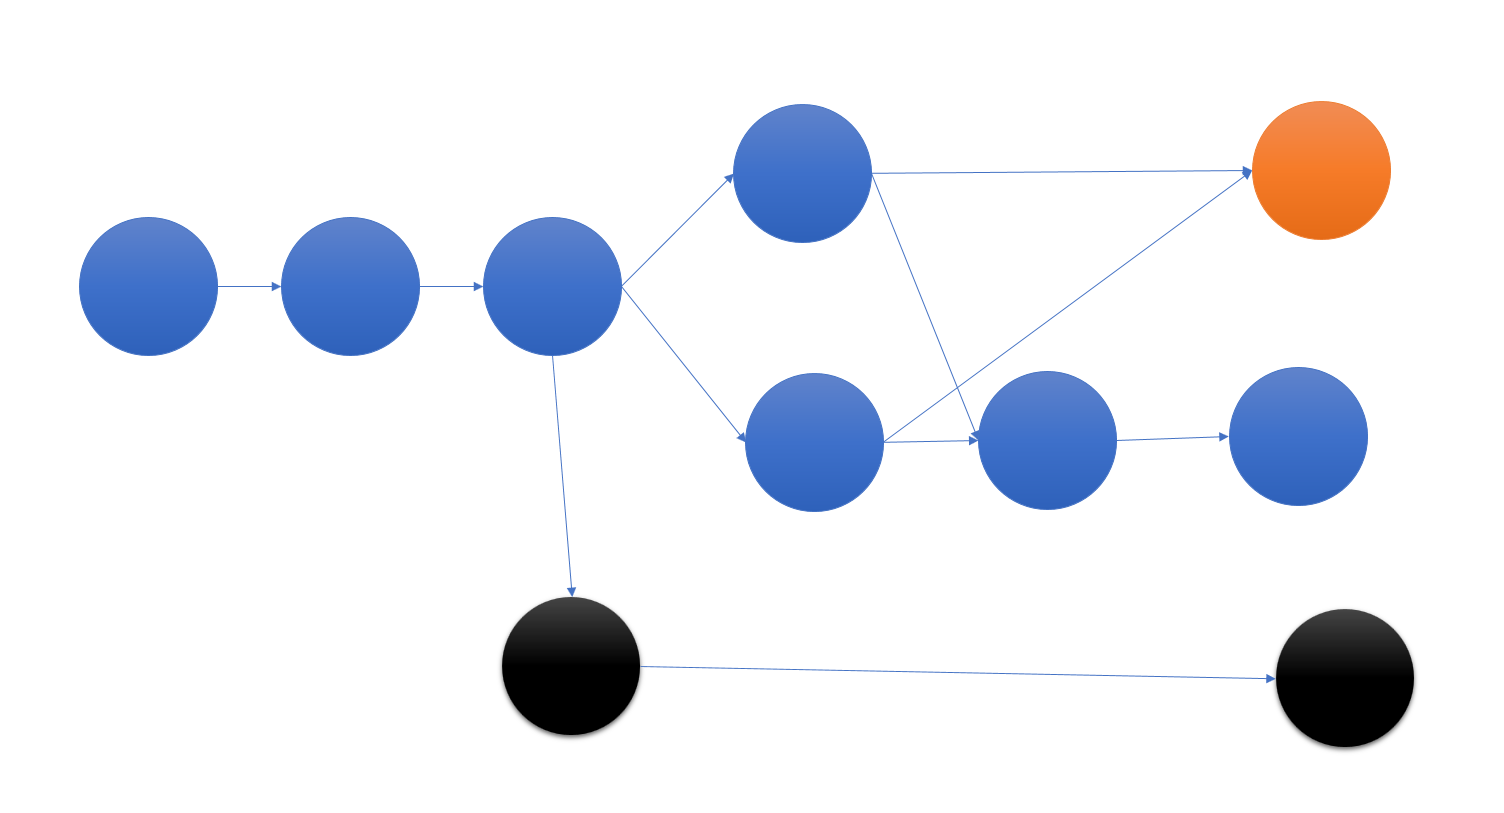
NeuronStorm的最小逻辑单元为Neuron,可以理解为逻辑单元,不同的Neuron可组合成业务流,通过组织Neuron单元形成业务流,使得代码逻辑流可以可视化呈现。

复杂的NueronStorm逻辑流程图

复杂的NueronStorm逻辑流程图

NeuronStorm是一个可视化的编程平台,依据设想,基于NeuronStorm的程序,只需要集中在Neuron单元中编写业务逻辑,通道代码由NeuronStorm集群控制。NeuronStorm借鉴了Apache Storm的Bolt概念,注重于可视化编程。

目前NueronStorm处于概念阶段,github的存储库已经建立起来,有兴趣的可以加入进来。

https://github.com/Lancker/NeuronStorm

巧妙拆分bolt提升Storm集群吞吐量

发表在 未分类 | 留下评论

巧妙拆分bolt提升Storm集群吞吐量 增加并行处理速度 Storm & kafka处理实时日志实战topology经验谈

巧妙拆分bolt提升Storm集群吞吐量

巧妙拆分bolt提升Storm集群吞吐量

项目背景介绍:

我们通过日志系统跟踪每个接口的运行状态,收发时间,平均速度,成功率,平均响应时长。日志被收集到了kafka,日志实时处理采用storm框架。一个请求有一条服务接收日志,一条服务器响应日志。需要通过日志实时处理,统计出每个接口的每分钟的指标,存到ES。

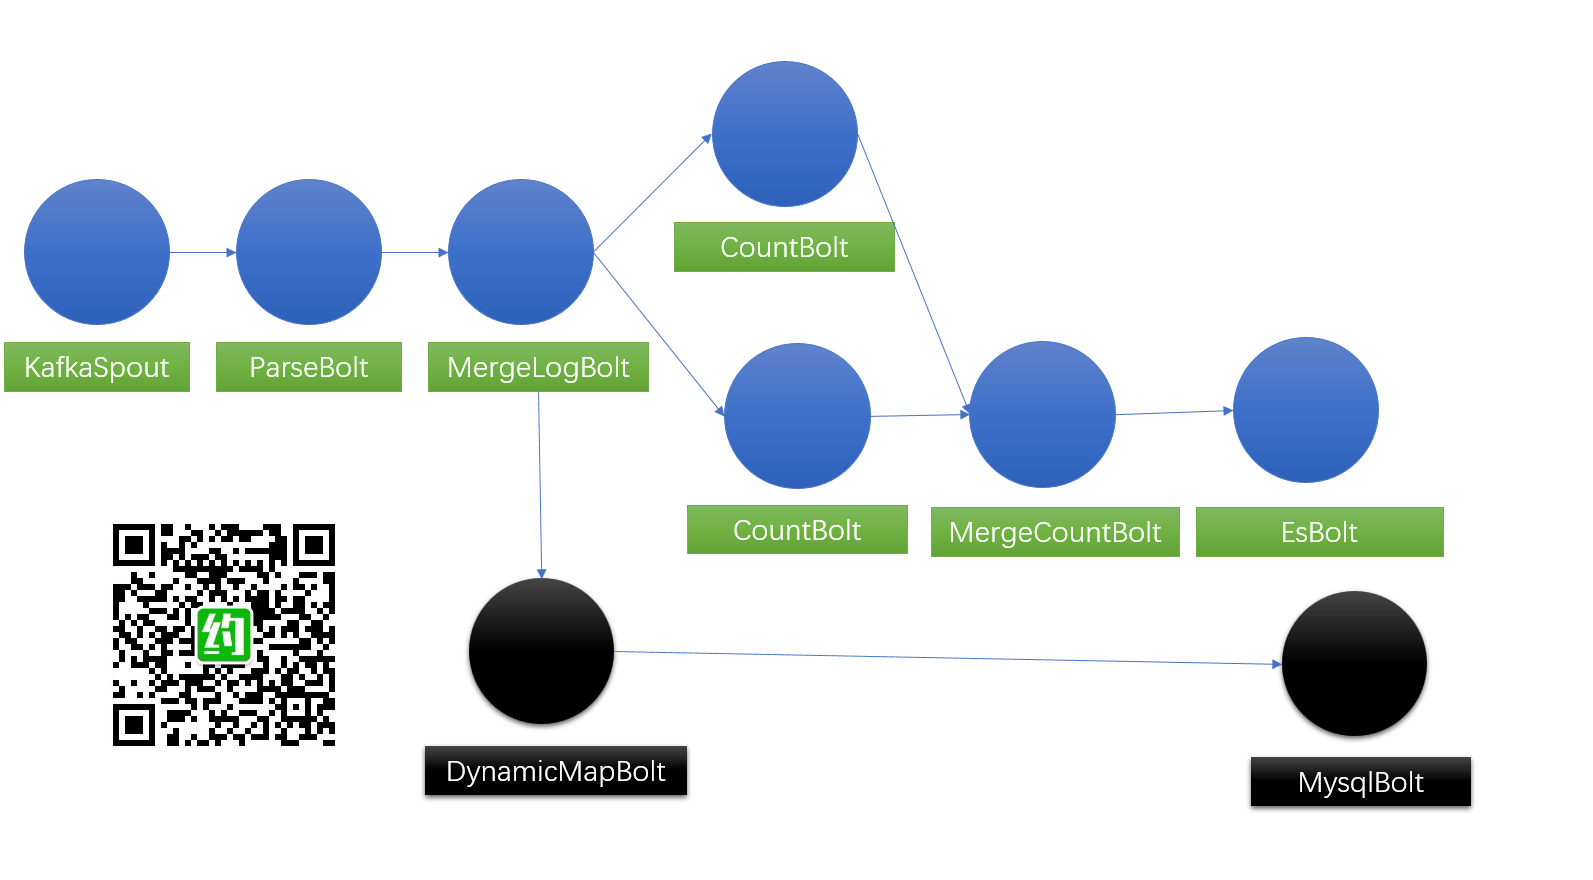
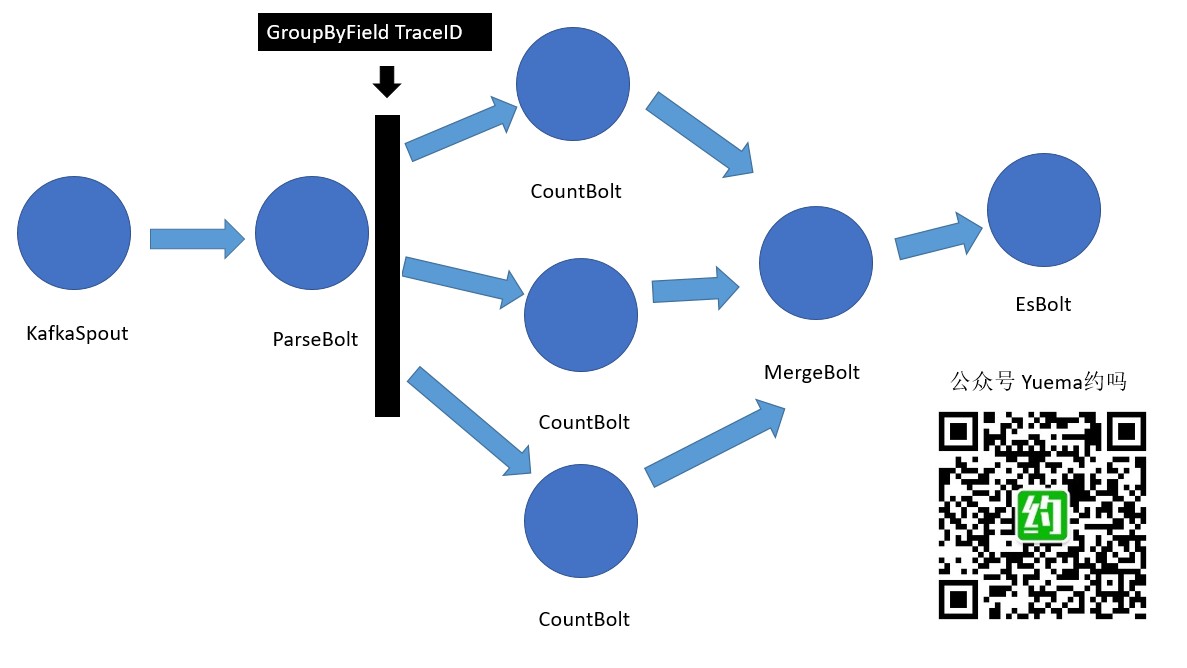
昨天的Topology图画成这个样子,如果有看过昨天的文章的话,应该还有印象。

Storm & kafka 日志统计代码流程转成多个Bolt

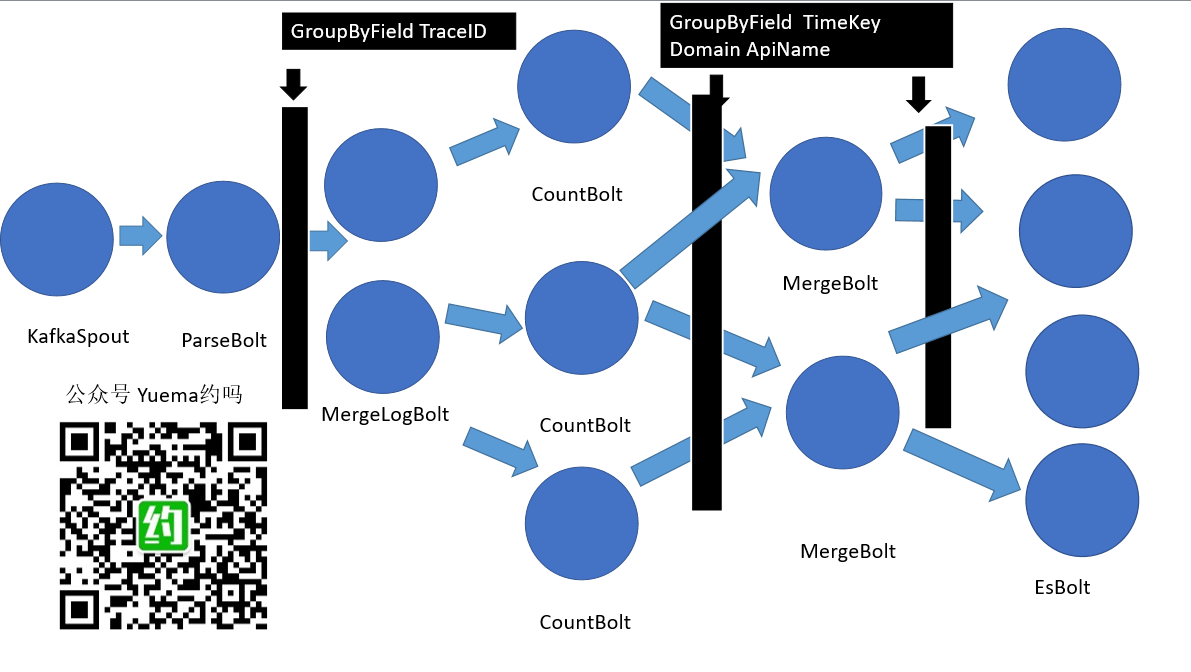
昨天写文章的时候,就思考要不要将CountBolt拆成MergeLogBolt加CountBolt,原来在一个CountBolt中即要做日志合并,又要做统计。今天整理代码的时候反复的思考,考虑到并行度的、代理管理维护、协作开发,多个维度,同时也考虑代码逻辑清晰度,果断拆开了。所以今天的图变成了:

巧妙拆分bolt提升Storm集群吞吐量

巧妙拆分bolt提升Storm集群吞吐量

如果细心看的话,每一个bolt都可以调整并行度了,可以依据每个bolt的处理速度配置合理科学的并行度。比如,要是EsBolt慢,可以增加EsBolt并行度,如果EsBolt并不是瓶颈所在,一个EsBolt也可以的话,可以配置为并行度为1。同时还可以考虑调整bolt之间的流控制,综合日志特点再调整并行度配置,从而提升集群处理的吞吐量。

目前我们拆分的Bolt细化到了PareBolt,MergeLogBolt,CountBolt,MergeCountBolt,EsBolt,划分原则如下:

1、单一职责,每个Bolt仅做一件事情。比如MergeBolt,CountBolt,原来是划到一个CountBolt,进行代码梳理的时候发现,MergeBolt需要维护一个组装log的HashMap,并要定时进行清理一定时间窗口未组装成功的孤立日志,组装成功的要及时从HashMap 中删除。而CountBolt维护统计数据是按timeKey,域名、业务名来组织 HashMap,时间窗口的处理逻辑完全不一样。对于MergeLog来讲,组一个删除一个,再定时清理孤立日志就好。而CountBolt则不一样。感觉夹杂在一起,给同事介绍起来也费劲,代码组织也不够清晰。拆成两个bolt之后,感觉代码逻辑更加清晰了。也更好的利用Storm提供的实时计算能力,可依据计算情况,为每个bolt设置相应的并行度,达到更高的吞吐量。简单的来讲,就是将一个大的逻辑,拆成一个一个小的逻辑,用tuple串起来,每个bolt都有明确的输入tuple,明确的输出tuple,也好进行代码逻辑问题定位。

2、协作原则,相对于在一整串代码逻辑中去写逻辑,别人读懂代码会更加费劲,往往是懵menbelity,而划成一个一个bolt之后,一个bolt的逻辑更加简单好懂。每个Bolt拿到tuple只做一件明确的事情,可以更好的并行开发。大家只要约定好输入的tuple,产出的tuple。比如,我们将Es操作划成一个Bolt,落地数据的小伙伴只要专注于Es操作,做合并的小伙伴只要专注于合并。哈哈,是不是很神奇。

收尾,这是一天下来的工作心得,对bolt的划分经验也是经过不断进行代码整理思考的结果。开始是在一个bolt里完成业务所需的所有逻辑,之后才拆成一个一个bolt来对待,并不是一上来就拆成一个一个bolt,第一天的时候比较担心日志无法成对的问题,所以都不敢拆,实验完GroupByField之后才敢拆。这个是有一个过程的。首先要知道业务要干什么,打算怎么实现,拆的话会引起什么问题,怎么解决,经过同事的指点与摸索,算是有了些心得,至少现在拆分出的几个bolt,基本上感觉是OK,已经是拆到一个合理的地步了。当然我也是刚玩Storm,如有好的bolt拆分心得,也欢迎指点,欢迎分享分享。

巧妙拆分bolt提升Storm集群吞吐量

巧妙拆分bolt提升Storm集群吞吐量

发表在 未分类 | 留下评论