JBlog 15年技术大神带小白玩开源项目 梦想从这里启航 一代技术人带新人见证技术变迁

个人参与JBlog预期收获

  1. 从0学会玩开源
  2. 从.net转java绝佳的练习,15年技术大神带队
  3. 学会Git
  4. 学会自动构建
  5. 学会服务器管理
  6. 学会博客系统架构
  7. 免费的科学上网指导,技术资料不再有国界

企业参与收获

将公司团队打造成一支敏捷开发团队,构建全自动的CI系统,理顺研发流程,持续的产品研发交付能力​!​

正文

每个开源项目的背后,都有一群为梦想执着的人!从asp+access到.net+mssql到php+mysql到java+mysql,见证技术变迁!用过wordpress,用过blogengine,用过phpcms,用过dedecms,各式各样的建站系统!随着版本的迭代,很多产品越来越成熟,也离梦想越来越远!很多时候,功能越多,并不意味着适合自己。

对于写博客来说, WordPress是很流行,我也是一名wordpress用户,但是一直磨灭不了自己要写一个自己的博客小系统,感觉自己写的,才能真正满足使用需求,而不是被别人所牵引。

相信很多人都有这么一个小小梦想,就是拥有一个自己的小系统,亲手打造,能被众多“信徒”所喜爱。很多人没有亲眼见证过一个系统从无到有,从无人使用到广受欢迎的历练过程。或许JBlog是一个小白成长的不错选择。

JBlog发起人是一位技术大佬,拥有15年工作经验,从大佬的博客上所见,在大数据搜索、游戏开发、自动构建、技术管理、CMS系统架构、网络管理等领域都有深入的研究。

JBlog将从无到有,从一个简单的小博客逐渐壮大起来!这个过程是漫长的,值得期待了,更是小白的一次历练机会!学会从无到有,从0基础到掌握系统研发、架构、管理!

关注大佬的公众号,参与JBlog开源项目!

如何参与?

JBlog是托管在Github.com上面,对于Github的使用,大佬的公众号都有讲,就不废话了,关注公众号去看吧!

JBlog部署

JBlog的文档在大佬的公众号里都有提到,不再赘述!

代码贡献

JBlog采用Github管理,代码贡献要通过大佬审核,大胆的fork,push吧!

关注大佬的公众号:海哥聊技术

发表在 未分类 | 留下评论

用Elasticsearch打造自主站点内搜索引擎 用开源技术成就个性化搜索 带小白玩转es开源搜索 No Code Talk

提到实现搜索功能,很快就想到sql的like模糊查找 ,很快就想到Lucene、Elasticsearch、solr,这些都是要实现搜索功能的关键术语。今天将分享的是采用Elasticsearch打造自主站内搜索引擎的实战经验分享。本文不是讲原理,不是分析es源代码,也不是讲es故事的,仅从应用角度,带小白运用es打造一个简易的搜索引擎。

一、为什么要使用elasticsearch

选elasticsearch,冲着开源免费,内置Lucene分词,在主自搜索引擎这块,es还是很有名气的。相比较于关系型数据库,elasticsearch倒排索引,能有更加高效的搜索性能。对于一般企业来讲,重复造轮子的成本太大,使用es算是一个不错的选择。

二、自主搜索引擎的基本组成

自主搜索引擎主要由elaticsearch安装、数据同步服务与Elastic Search High level API三大块组成。下面分别介绍这三大块。

2.0 安装elasticsearch

安装教程之前有专门写了一个小白序列,可以参考。

Storm Topology : Elasticsearch & Redis 构建实时性低延时数据统计分析 呈现大数据分析效果

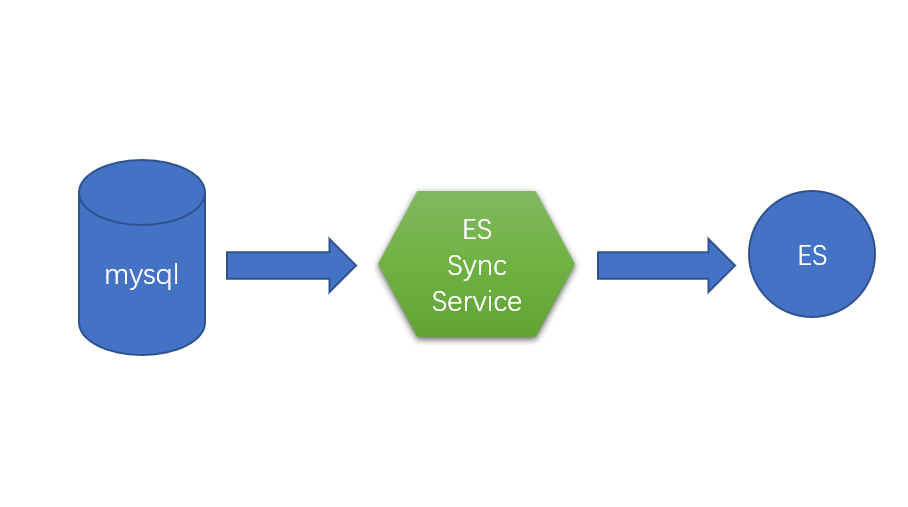
2.1 数据同步服务 建立es索引

数据同步服务,即将需要用于搜索展示的数据组装好,同步到es,这个过程是利用es建立索引的过程。服务一般以后台服务的形式定时执行。我们的做法是,针对需要查询的数据,写操作日志,包括增、删、改操作,同步服务定时检查日志,将数据同步到es上。一般是多个表组合好的业务数据,对应es上的一个索引类型。若是同步服务写得好,应该可以将同步服务做成透明的,通过配置,直接将数据对接到es,显然,我们没有造这种“面包机”,我们在mysql里有建立操作日志,专门用于es同步。同步服务会记录操作日志进度,不断同步业务数据到es.基本上,写完这个服务,基本上就完成很大一块工作了,成功的希望就在眼前。

关注ChinaHadoop公众号,回复”Elasticsearch”可获取一份《创建index和type.txt》

2.2 使用elasticsearch High Level API查询数据

准备好了同步服务,有了索引数据,接下来就是使用数据了。在这里推荐使用的是elasticsearch High Level API,为什么不推荐其他api或映射框架?因为我就会这一种方式啊!算是抛砖引玉,想了解更的方式,可以关注公众号,期待下一个回合。

你可能会见到的包引用,以java为例

POM包

<!-- elasticsearch.client -->      <dependency>        <groupId>org.elasticsearch.client</groupId>        <artifactId>elasticsearch-rest-high-level-client</artifactId>        <version>6.7.2</version>      </dependency>
import org.elasticsearch.action.DocWriteResponse;import org.elasticsearch.action.delete.DeleteRequest;import org.elasticsearch.action.delete.DeleteResponse;import org.elasticsearch.action.index.IndexRequest;import org.elasticsearch.action.index.IndexResponse;import org.elasticsearch.action.search.SearchRequest;import org.elasticsearch.action.search.SearchResponse;import org.elasticsearch.action.update.UpdateRequest;import org.elasticsearch.action.update.UpdateResponse;import org.elasticsearch.client.RequestOptions;import org.elasticsearch.client.RestHighLevelClient;import org.elasticsearch.common.unit.TimeValue;import org.elasticsearch.common.xcontent.XContentType;import org.elasticsearch.index.query.BoolQueryBuilder;import org.elasticsearch.index.query.QueryBuilders;import org.elasticsearch.search.SearchHit;import org.elasticsearch.search.builder.SearchSourceBuilder;import org.elasticsearch.search.sort.FieldSortBuilder;import org.elasticsearch.search.sort.SortOrder;

其他语言的就不帖了,可以到官方站点寻找。感觉官方还是有所保留就是。使用Elasticsearch High Level写查询,相比较于sql,会有一种强烈的不适感,应该有现成的工具可以将sql脚本转化为elasticsearch High level对应的查询代码吧,在这里简单晒一下查询代码的一点神态。

BoolQueryBuilder boolBuilder = QueryBuilders.boolQuery();boolBuilder.must(QueryBuilders.termsQuery("title", “ChinaHadoop”));boolBuilder.must(QueryBuilders.termsQuery("content","公众号"))

不要太惊讶,就是这么晦涩与不爽的节奏!写习惯的sql,再来写这种“奇葩”的查询代码,是不是有种“生无可恋”的感受?不用太担心,关注ChinaHadoop公众号,回复”Elasticsearch”可获取一份小白 demo,初始化High Level API Client,定位index,type,多种查询条件代码,覆盖常见查询场景,完全不用烧脑,享受ChinaHadoop干货经验,快速打造自己的搜索引擎!

本文从应用的角度介绍了如何运用Elaticsearch搭建自主的搜索引擎解决方案,从环境安装、索引建立、同步索引数据,到使用Elastic High Level API进行数据查询,覆盖了一个简易自主搜索引擎的全生命周期,小白可参考本文实现一个自主搜索引擎,遇到问题可回复ChinaHadoop,得到指导与帮助。

关注ChinaHadoop 走进大数据实战

技术岛公众号

技术岛公众号


发表在 未分类 | 留下评论

ChinaHadoop携手图书云打造大数据主题图书馆 免费企业图书馆 私人图书馆 共享图书更加便捷高效 扫码即刻开启图书共享时代

图书云为共享图书平台,通过图书云微信公众号可将自己的闲置图书共享出来,建立自己的微信私人共享图书馆,可与附近的朋友、同事、好友、群友、同学、邻居、俱乐部成员等分享自己的图书!也许,自己沉睡的图书是他人成长的阶梯!通过图书云,可以打造私人图书馆、企业图书馆、小区图书馆​!

本次ChinaHadoop携手图书云活动分为微信私人图书馆与企业图书馆两大活动主题!关注图书云公众号可开通私人图书馆,将自己的图书共享到平台,就近分享,特别适合​邻居、同事共享图书!动手能力强的可以自行扫码探索!想先了解的,可以扫码后,看看ChinaHadoop为图书云开设的介绍​!

图书云公众号二维码

图书云公众号二维码

一、私人图书馆

每个IT人士,或多或少都会有些​图书,这些书一点也不便宜!尤其是外文原版图书,看完也舍不得丢了,当废品卖了,更是​心疼!建立一个自己的私人小图书馆,让朋友邻居借着看,感觉就是不​一样!

1.1 巧用扫码录入

图书云支持扫码录入图书,扫图书的条形码,可直接将图书录入到平台,结合lbs技术,可让周围的朋友看到自己的图书!快速高效录入!

1.2 巧用书单码

图书云书单码是私人图书馆的快速入口,分享给朋友后,可让朋友进入到自己的私人图书馆中,浏览图书清单!支持分享到朋友圈,与圈里的​小伙伴共同图书!

1.3 实时微信提醒

关注图书云公众号之后,一旦有小伙伴相中的图书,能收到微信的实时提醒​!通过图书云小程序,可与借书的小伙伴进行实时文字聊天​!约时间、约地点,完成一次图书的​借阅!

二、图书云企业图书馆

图书云支持企业微信,通过图书云企业微信入口,可由企业微信管理员开通图书云企业微信功能,还未开通企业微信的企业负责人,可直接通过以下二维码​进行开通!非企业微信管理人员,无法直接开通,需要找管理员扫码开通!图书云​企业版,也是免费的!

图书云不仅支持私人图书馆、企业图书馆,也支持更多应用场景,可建立社区图书馆、微群图书馆、俱乐部图书馆、社区图书馆!更多的应用​场景等着大家去发现!ChinaHadoop欢迎各位小伙伴共享Hadoop大数据图书,共同建立以大数据为主题的线上​虚拟图书馆!

图书云  共享创建价值

发表在 未分类 | 留下评论

敏感词过滤算法 为内容保驾护航 Java/.Net/C++/c/Python等语言是如何进行敏感词打码限制的 高效防范违规内容

有人的地方,就有江湖,有输入框的地方,就有注入风险!有输入框的地方,就有敏感词!敏感词就像一个平台杀手,可能直接导致平台被封锁!

敏感词是一个APP、一个网站、一个内容平台的“杀手”,危害程度杀伤力相当大。将一个文本中的敏感词过滤掉,是一个合法合规平台所必须使用的技术。敏感词的过滤算法是关键词查找、过滤打码的过程,可有效结合时间复杂度高效的树型结构进行算法设计与实现!

敏感词可能是脏话,也可能是不同文化背景下的禁词,也可能是政治敏感词汇,等等,敏感词可能导致平台遭受法律或政策的制约。举个简单的例子,非法涉黄的网站可能直接被取消网站备案,无法在中国大陆访问。不做敏感词的后果是相当严重的。

做为一个程序员,一个开发工程师,一定要掌握敏感词算法么?工程师分为很多派系,对于做搜索的工程师,算法,b树,敏感词过程,应该要从底层,从设计到实现都不能放过!做为应用工程师(小白程序员),能掌握算法原理,并能使用,我觉得就好了,树叶有专攻!来来来,来一段算法描述。目前查到的敏感词过滤算法。

一、敏感词少的情况

如果敏感词少的话,就直接使用replace,indexOf等等来搞定吧,只是这种情况存在的可能性太小了。敏感词可以说是很多很多。不过,不讲究效率的地方,能实现业务要求的话,使用这种方式也可以。

二、敏感词较多的情况

敏感词受政治、人文、种族各种因素影响,词汇量较多,要做到全面的过滤,自然要考虑考虑算法的设计,以保证过滤的高效性。在这里介绍网上流行的一种敏感词过滤算法。深入了解专业算法已经超出了本文的范畴,请自行找其他资料查看。网上流传的算法,主要是将敏感词库放到树型数据结构中,将带过滤的文本投射到敏感词树上,命中的就是踩到敏感词。用树型结构体加速匹配速度。

2.1 构建敏感词树

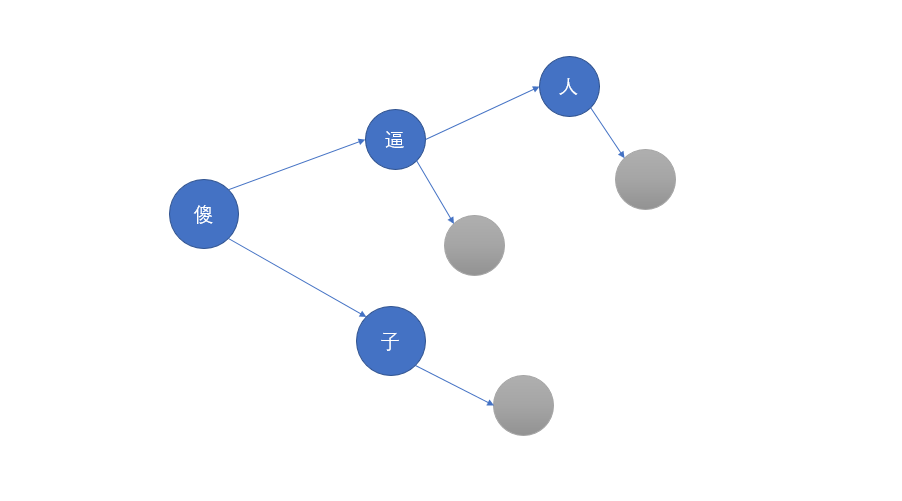
什么是树?主要是树型结构在时间复杂度上有优势。详细了解时间复杂度与树型算法,关注公众号回“算法”!今天不展开介绍树型结构。构建敏感词树型结构体,可以通过第三方库来完成,有现成的。回复公众号“敏感词库”可获取相关信息。如图所示,我们构建了一棵敏感词树,这棵树有傻子、傻逼、傻逼人三个敏感词​。

2.2 投射文本

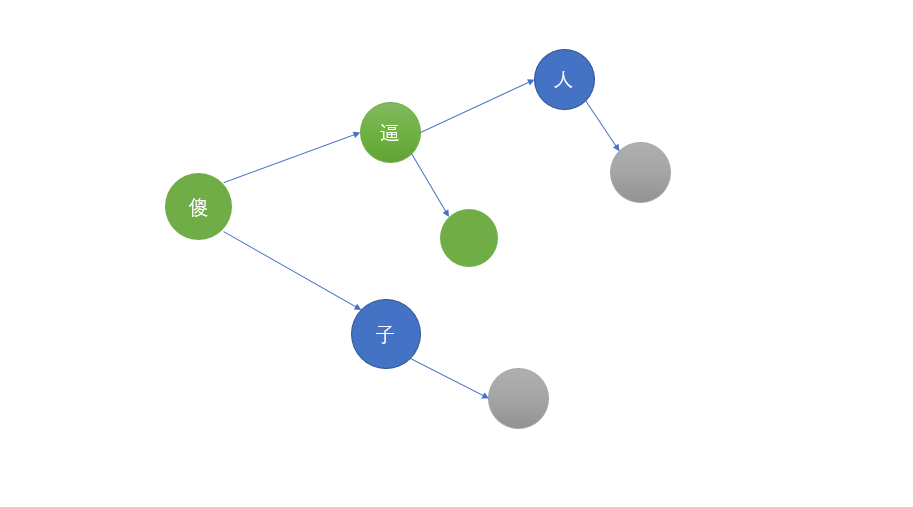
把文本填充到敏感词树上,就能直观的看到哪些敏感词覆盖到了。如果有人在平台发布违禁信息,可以快速识别出来。在这里使用投射文本描述,只是为了描述算法,具体实现就看代码。如图所示,投射到树上文本“傻逼”,就是被发现的​敏感词。

敏感词过滤算法的核心就是这两步!一棵敏感词树,一次投射文本,就能把敏感词全遍找过来,高效​!

今天的算法分享就要告一段落了,赶紧播放赞助商广告!

技术岛公众号

技术岛公众号


发表在 未分类 | 留下评论

WebService传奇故事 这是.Net、Java、C++语言的大战, 也是微软 与 IBM等厂商的PK,于是小白爬坑之路开始

WebService实战经验分享

WebService实战经验分享

说到WebSerivce,会想到很久很久前的SOAP,第一次看到的时候,觉得就一个神马。在.Net环境下使用过,导入WebService,直接使用,似乎也是很实用的一种跨平台跨系统的操作体验。单纯在.net体系,是感受不到WebService的阵痛,在java下,才是WebService爬坑的最佳土壤。这个故事的主题在于java与.net两个平台实现的差异,在于厂商实现的异常。

一、.Net vs Java

相比较于java,.net体系下的WebService,选择更单一,用ms的就好,直接用ide导入webservice。玩java的话,axis1,axis2,ide导入,wsimport命令生成,还有wsdl2java命令。

二、厂商之争

就实战经验来看,不同的厂商对soap的实现,还有差异。.net发起的soap报文是<soap>开头,而java发起soap发起了soap:env报文。导致跨平台调用的时候出现问题。

方案一 ide导入

直接使用eclipse导入WebService,同样的方式导入,STS却导入不了。所以实操过程中,选择eclipse导入。针对java平台的WebService调用,调用正常。但是调用一个神秘的WebService,一直报soap报文格式不对。如果没有记错的话,当时eclipse导入WebService,生成的是axis1的实现。网查axis1对于soap请求头处理,就是一个Bug。所以方案一,被丢掉了。

方案二 前辈方案+axis2

想着axis1搞不了的事情,兴许axis2能做。当被告之有方案借鉴时,感觉看到了希望。不过,没有看到操作手册,也不知道代码是怎么生成的。从包引用上来讲,用的是axis2,这个就是为什么有axis2方案尝试的原因了。也是迷惑人的地方。因为引入的包,压根没有使用到。但是从代理类的生成风格上来讲,还是具备排版精良的影响。使用axis2的代理类生成工具,生成完代理类之后,吓死了,感觉生成的代码就是一团芝麻糊,于是,直接丢掉了。为什么别人生成的axis2代理类这么优秀,而我生成的惨不忍睹?

方案三 wsimport方案

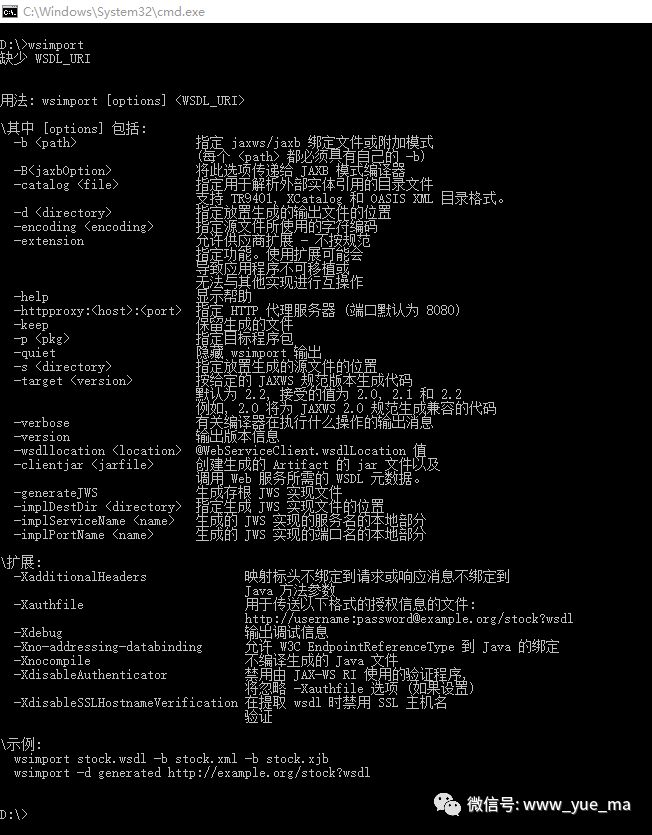
绕了半圈,回到了java sdk自带的wsimport,直接在命令行输入wsimport,会有提示。存放代理类的文件夹不存在的话,还不给生成,这个有点小小的坑。

wsimport command

wsimport command

D:\>wsimport缺少 WSDL_URI用法: wsimport [options] <WSDL_URI>\其中 [options] 包括:  -b <path>                 指定 jaxws/jaxb 绑定文件或附加模式                            (每个 <path> 都必须具有自己的 -b)  -B<jaxbOption>            将此选项传递给 JAXB 模式编译器  -catalog <file>           指定用于解析外部实体引用的目录文件                            支持 TR9401, XCatalog 和 OASIS XML 目录格式。  -d <directory>            指定放置生成的输出文件的位置  -encoding <encoding>      指定源文件所使用的字符编码  -extension                允许供应商扩展 - 不按规范                            指定功能。使用扩展可能会                            导致应用程序不可移植或                            无法与其他实现进行互操作  -help                     显示帮助  -httpproxy:<host>:<port>  指定 HTTP 代理服务器 (端口默认为 8080)  -keep                     保留生成的文件  -p <pkg>                  指定目标程序包  -quiet                    隐藏 wsimport 输出  -s <directory>            指定放置生成的源文件的位置  -target <version>         按给定的 JAXWS 规范版本生成代码                            默认为 2.2, 接受的值为 2.0, 2.1 和 2.2                            例如, 2.0 将为 JAXWS 2.0 规范生成兼容的代码  -verbose                  有关编译器在执行什么操作的输出消息  -version                  输出版本信息  -wsdllocation <location>  @WebServiceClient.wsdlLocation 值  -clientjar <jarfile>      创建生成的 Artifact 的 jar 文件以及                            调用 Web 服务所需的 WSDL 元数据。  -generateJWS              生成存根 JWS 实现文件  -implDestDir <directory>  指定生成 JWS 实现文件的位置  -implServiceName <name>   生成的 JWS 实现的服务名的本地部分  -implPortName <name>      生成的 JWS 实现的端口名的本地部分\扩展:  -XadditionalHeaders              映射标头不绑定到请求或响应消息不绑定到                                   Java 方法参数  -Xauthfile                       用于传送以下格式的授权信息的文件:                                   http://username:password@example.org/stock?wsdl  -Xdebug                          输出调试信息  -Xno-addressing-databinding      允许 W3C EndpointReferenceType 到 Java 的绑定  -Xnocompile                      不编译生成的 Java 文件  -XdisableAuthenticator           禁用由 JAX-WS RI 使用的验证程序,                                   将忽略 -Xauthfile 选项 (如果设置)  -XdisableSSLHostnameVerification 在提取 wsdl 时禁用 SSL 主机名                                   验证\示例:  wsimport stock.wsdl -b stock.xml -b stock.xjb  wsimport -d generated http://example.org/stock?wsdl

照着命令行的提示来,就能生成代理类了。

采用wsimport生成的代理类竟然跟4年前同事留下的对接项目代码是一样的,于是修改soap:env就有着落了。实战证明,前辈们留下的代码管用。关键的代码就是自己实现一个报文处理的Handler,然后在Soap代理类调用时,先设置Handler!

wsInstance = new WS();        wsInstance.setHandlerResolver(portInfo -> {          List<Handler> handlerList = new ArrayList<>();          handlerList.add(new SOAPEnvelopeHandler());          return handlerList;        });

关注本公众号,输入soap获得SOAPEnvelopeHandler详细讲解。

方案不足之处

采用wsimport生成的代理类指定了wsdl位置,这个看起来怪怪,但是这种方案能修改soap请求报文,可以默认接受了这个让人心头有点痒痒的方案。

WebService优化

采用单例优先代练类的创建,能提升压测值。在未使用单例优化时,空接口也无法通过5000/min压测,采用单例优化后,可以通过。最终的优化方案为:

  1. 能缓存的,使用redis缓存60秒。过压测。
  2. 不能缓存的,过不了压测,限制每分钟调用频率。

受控环境下的WebService联调技术

如果开发机器不能直接调用对方的WebService,如何进行快速联调呢?关注本公众号,回复信息wsdebug,获取实战经验分享。

WebService与区服切换

回复信息switcharea,获取实战经验分享。

思考

今天的思考题:sonarqube报很多漏洞很多bug的代码是不是好代码?请留下您的思考答案。

结束语

WebService从诞生到现在,越来越不受待见了,越来越多的人喜欢采用更轻量级的WebAPI来代替WebService,采用JSON,采用更加透明的跨平台方案。但是WebService并没有死,因为生成代码还是一个优点。如果再次在java平台下对接WebService,请优先考虑jdk自带的wsimport进行代理类生成,可通过自定义SOAPHandler达到更好的兼容性。如有更好的方法,请留言告之。

关注公众号 看同行经验分享

技术岛公众号

技术岛公众号

发表在 未分类 | 留下评论

压测如同照妖镜 妖怪哪里逃! 业务代码、核心代码、机器配置通通无处遁形 藏得再深,藏得再久,也逃不出压测的猛烈攻击!压测实战分享

压测如同照妖镜 妖怪哪里逃! 业务代码、核心代码、机器配置通通无处遁形 藏得再深,藏得再久,也逃不出压测的猛烈攻击!压测实战分享是这阵子感触比较深的!压测在于暴力,在于并发,在于无情。一个铁的事实标准摆在面前,从配置到代码,从业务到核心,从cpu到硬盘,从网络到逻辑,方方面面,能争取一秒算一秒,能榨一毫秒算一毫秒!压测能把潜伏在系统里的深层Bug暴露出来,经典到格致,让人难以忘却所在所闻!下面从几个方面分享一下。

一、压测反推工程结构

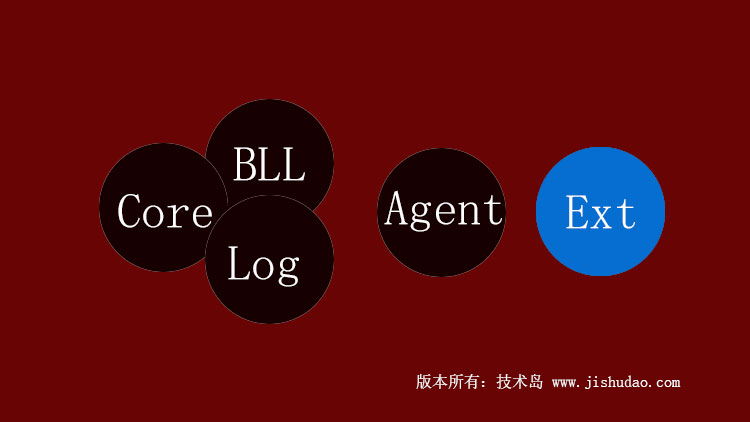
压测与代码工程结构的千丝万缕关系。从压测的角度来看,代码至少要分成两部分,一是可控代码,简单的说,就是项目中的业务代码,因为是自己写的,所以可控性很强,压测的时候,可以针对性优化;二是不可控代码,像调用的第三方接口,这种没法自主控制。如图示,agent中存放与第三方交互的代理类。压测的时候,区分开可控代码与不可控代码。可控的代码就自己优化 ,不可控的代码,如果是公司团队提供的,就去沟通一下吧,对于外部公司的Agent,那真的是超级不可控了,直接忽略吧。在工程结构上来分析,建议Agent的异常要及时抓住并记一条神奇的【甩锅】日记,看看日志,就能快速定伴Agent对应的团队人员,找到快速处理问题。最好,把第三方的交互统一加上try-catch,记下异常。这样子,可控与不可控就划得很清楚了。
二、不要迷信核心代码

使用核心代码公共类库是一件很开心的事情,省下很多不必要的时候,省下的不仅是时间,更是一堆堆重复代码,可以让人关注业务。然后,千万不要迷信核心类库的代码,所谓有人的地方就有江湖,有代码的地方就有Bug。

这次压测,压到一个神奇的核心库Bug。具体表现为,controller捕获了2%左右的失败,有时候又没有错,这个错误一直在0%到2%的样子。为了查这个压测失败的问题。查看失败日志,能定位到Ip获取环节。但是不知道为什么会失败,断点调试,一切都是正常的,只是压测的时候,总能重现异常。

难道核心库有问题?这个简直不敢想,对于核心库,一直以来都是膜拜啊,拿来用,没有想过核心库会有Bug。但是面对压测的数据,又没法排除核心库的嫌疑,只能对核心库代码进行排查了。

如果构建核心库的时候,把源代码打进去,我觉得对于使用者来讲,绝对是一个福音。可惜我面对的这个核心库没有,还好之前把源代码打进去了。单个调试一切显示正常,压根调试不出任何问题。简单就是诡异到头了。

肿么办,抓掉几根头发后,突然灵光一闪。直接把代码Copy出来,将ip获取的代码逻辑加上步骤日志,从第一步到第六步,一一打出来,进行压测,日志显示,所ip获取的时候,步骤都是正常的。但是期间能出现还是出现了异常。看步骤的话,从request中取ip的代码逻辑并没有出现bug。面对诡异的压测结果,那就再想想。

看样子,从reqeust中取ip的逻辑没有问题,那就把取ip的地方加上try-catch抓一下日志。果真发现Bug了,使用ip的时候,出现了ip为空,导致异常了。

再往回看代码,发现static,发现new,一下子,抓到了Bug,这可是14年种下的bug,19年才来杀。这段代码的bug,可以描述为static误用。来来,展示一下bug的样子,希望你不要写出这种级别的bug,不好发现,不好杀,sonarqube查不出来,普通使用,一切正常,只有压测才会现形。花了8个小时才杀,不要问我为什么花了这么多时间。当核心代码在sonarqube的检查下,呈现出很多bug,很多坏外道。核心类库,想说爱你不容易~

static误用示范public class Ip{
 private string address; 
 private int ipNumber; 
 private Ip ip;  
private Ip(){   
 //sonarqube说禁止外面创建实例  
}  
public static getIp(Request reqeust){   
 ip = new Ip();   
 ....    ...    
//相信我,这里是复杂的ip识别与获取逻辑
...    
...  
}  
public String getIpString(){
     return ip.address;  
}}

压测的时候,不要迷信核心类库,把工程分成三大块,业务代码,核心类库,agent,对应三种不可控级别的代码。业务代码自己搞定,核心类库慎重的找人处理,并[AT]尽量多的人,Agent找人处理或者直接排除掉。

三、压测与机器配置

机器本身配置不行的话,压测就凉凉了。同事测试了机器硬盘读写性能,发现硬盘读写就把时间消耗没了,更不要谈压测业务代码了。提供一台标准的压测机器,是合理的前提。压测不过,不仅仅是代码,这一压,也得看机器本身性能。

压测就像一面照妖镜,英雄不问出处,是驴是马,拉出来溜溜就知道了。面对事实的标准,如何才能将压测做得更好呢?

1、压测环境与压测要匹配

在一个标准性能环境下,达到一个预期的压测值。这个标准环境,比如cpu,硬盘读写性能,可以是一个标准的。或者拿一个基准接口进行压测定值,先测算出环境本身适合的压测值。这样子,压测才能正常的进行。

2、压测环境最好有多个

接口多,接口要一个一个压,一个环境不好并行压。能有多个环境最好。不知道下次压测能不能实现,毕竟要有机器。

3、核心类库必过压测

核心类库都过不了压测的,放在核心类库里,这个有点点坑啦。又要用核心类库,又要过压测,没解。核心类库打上源代码,压测的时候,还可以用源代码进行压测调试。但是希望是通过压测的才放进核心类库,不要等业务代码进行压测的时候,再来找出核心类库的Bug.

4、核心类库必过sonarqube

为什么又扯到sonarqube,其实这个工具的强大之处在于,能分析出很多坏味道与bug,人不同于工具,工具在于将所有可性能全面覆盖分析,人没人注意到的地方,sonarqube可以注意到。这次压测就发现,核心库代码的规范性,并没有想像的美好。sonarqube找出了一堆坏味道,还有bug.

这次压测实战,感觉收获还是很大的。对于工程结果的理解,对于异常的捕获处理,对于核心库的优化改进,都有了新的认识,对于压测,也有了自己一套方案。希望你也能从中学到宝贵的经验!

关注公众号,我的经验就是你的经验!

发表在 未分类 | 留下评论

单元测试的前世今生 与sonarqube的爱恨纠葛 写给小白看,小白可以看到一些技术,会有收获 大神请留言请吐槽指点一二 谢谢!

单元测试,问问自己写不写单元测试?

其实,工作10年了,都没有专门写单元测试,野路子写了这么多代码,即没有单元测试,也没有sonarqube,不知道留下了多少Bug在这10年的职场之路!有没有在入住酒店的时候,发现系统卡死了,有木有在银行开户的时候系统… …很开心是吧!

第一次写单元测试的时候,老把测试驱动开发混在一起。第一次看到powermock出来的单元测试代码,都想吐。这代码看起来真心的“恶心”至极。10行代码,也许得造100行单元测试代码出来,这可能说得稍微有些夸张,就是单元测试代码量超级多的感受。如果要实现100%的单元测试,简单会是一个极大的挑战。代码量会指数级增加。

关键词:Powermock

写单元测试,我说的是java,我们使用powermock、mock、testng这种东东,相信你知道怎么去了解更加详细的信息。这里就不帖一些没有态度没有温度没有人文感受的文字过来了。

秀几行

UserBean user = mock(UserBean.class);when(user.getUserById(anyInt())).thenReturn(new UserBean());doNothing().when(user).sayHello();

这是最常用的几行代码,基本上就是依靠他们,模拟所有代码行为进行单元测试。

恶心?

是的,第一次见到他们,不恶心才怪,得一点一点mock,对于静态类等特殊的成员,还得找法子去mock,把每个分支都覆盖到,最后实现100%的覆盖率。

单元测试的意义

之前我的感觉是单元测试是帮我们找出当前代码问题,而写完单元测试之后,到没有这种感觉,反而是,防止今后别人不小心破坏了当前已经验收通过的代码。如果按我们写mock的方式进行全面覆盖的话,别人只要改变一个逻辑,都可能导致单元测试失败,从而发现风险。

单元测试的权衡

因为我们只要求单元测试在service层实现100%的覆盖,所以我会爱上,单元测试,如果要在bll层,覆盖的话,我可能会改变哦。bll层太多的细枝末节,mock起来遇到一股意想不到的代码风暴。而service层则不同,对于我们来讲,service层是负责组装的,mock的时候就能巧妙的实现快速覆盖,避免mock中常见的特殊的静态类啊,还可以避免过多的if要覆盖。如果想要挑战自己的单元测试实力,那就是去写bll层的单元测试,嗯,相信是史无前例的挑战!

单元测试与sonarqube相爱相杀

单元测试要覆盖所有的逻辑分支,按copy复制再修改修改的写法,重复代码会直接捅破sonarqube的底线,直接不给过啊,重复率太高了。写单元测试的时候,都有种冲突,把sonarqube关掉,哈哈!不关sonarqube,那就得重用重用自己的代码,不能复杂一口气复制一遍testcase出来。

一招让单元测试powermock与sonarqube和平相处

单元测试可以看着源代码,一点一点mock,遇到一个if就给个开关控制,一路下来,就产生了很多开关,这样子就能通过参数来控制一个公用的testcase实现全分支覆盖,同时又不会引起powermock报警。

秀一下伪代码

@Test[name="登陆失败-验证码错误",enable=true]public void login_whenVerifyCodeError_thenFailed(){  login(false,false,false,false,false,verifyMessage);}@Test[name="登陆失败-帐号锁定",enable=true]public void login_whenAccoutLocked_thenFaild(){    login(true,false,false,false,false,verifyMessage);}... ...private void login(boolean isVerifyCodeOk,boolean isAccountLocked,...){ when(verifyAgent.check(verifyCode)).thenReturn(isVerifyCodeOk); ....}

这段伪代码是秀出最近摸索出来的,用来防止单元测试出现大量重复代码。通过传参,控制代码分支走向,达到即能覆盖到所有支付,又不会惹恼sonarqube.

巧用只在Service层写单元测试原则

service层写单元测试,也就是把琐碎的具体的业务代码放到bll层,service层保持一种组装bll业务的对单元测试友好的状态,就可以巧妙的避免写复杂的service层单元测试。为了,能快速搞定单元测试,这个原则可以合理的利用利用。还有一些小经验:

  1. 尽量不要把些特殊的类丢到Service层来使用,比如一些静态类,final类,方法什么 ,可以找静态类相关的mock方式,但是如果不把他们放进来,是不是直接可以绕过去?是好是坏呢?欢迎指点指点。如果从Service组装业务的定位来看,是可以的,把业务验证丢到bll层,这样子service层拿到一个bll层返回的业务结果,也巧妙的避免了用单元测试最可能出现代码大爆炸的地方。不好的是,可能在业务细节覆盖上就失去了精度。这种精度覆盖的放弃 ,也许也算是一件好事,不然,每写一点点代码,都可能导致大量的单元测试代码成本。
  2. 在service层避免try catch,单元测试不好搞,目前没有找到好方式把try catch丢给bll层,或者不要try,直接往外丢。往bll层放,也不错,返回一个明确的结果,就好进行单元测试覆盖。往外抛,不要try catch。一出现try catch,单元测试覆盖就显示尴尬了,有经验的可以分享分享。
  3. 发现service层不好进行单元测试的,就要思考,这些代码放在serivce层是否合适了,打包成一个小业务放到bll层。嘻嘻,你会发现,写单元测试真的好快.都把复杂性绕过去了。酱油党强力推荐,不要打我~


技术岛公众号

技术岛公众号

发表在 未分类 | 留下评论

一行代码三个Bug 专业写Bug十余载 False Unused “private” methods should be removed

不用不知道,一用吓一跳,原来这么多Bug,这么多坏味道。sonarqube就是神一样的存在,能把代码中各种不规范,各种逻辑漏洞,各种容易出问题的写法都一一指出来,并附带了详细的说明与修改参考,可谓是一个Coding利器。被sonarqube不断的“调教”,代码就越来越规范,整个团队的代码就越来越统一。这个过程是有点小小的煎熬。sonarqube就像一位不会生气的好同事,一点一点帮我把所有写得不好的地方指出来,再怎么煎熬也是值得。

相见恨晚

第一次见到sonarqube就非常喜欢TA,这远远超出了我早前设想的代码检查工具,采用反射+正则进行代码分析,既然有现成的sonarqube,我也没有太大的动力去实现这个梦想中的想法。这已经是第二次写sonarqube了,每一次写,感触都不一样。

sonarqube Bug

每次去坏味道,一个一个去,一个一个调整,处理到private method的时候,都有点抓狂,明明这个private methed被使用到了,却一直提示False Unused “private” methods should be removed,这个事情都有点冲动,想要写一个自己的代码分析器,不想被sonarqube调戏。今天查了好久的资料,终于在stackoverflow查到,这原来是sonarqube的一个bug,最新的版本,已经没有这问题了。

使用sonarqube的过程,就是养成一种coding习惯的问题,不用刻意去记要这样写要那样写,这规则那规则,跑起sonarqube,让工具来告诉你哪里不合理,哪里要调整,多经历几次 ,就自然的养成了一种全球化的规范coding习惯。

图书云公众号二维码

图书云公众号二维码

  1. 代码不要嵌套太深

​sonarqube会告诉你,代码不能超过三层嵌套,要直观明了,不能一层一层无限嵌套。try算一层if算一层while算一层for也算一层,一般来讲,不用sonarqube来检查,很容易凭自己的感觉写出深度嵌套的代码。嵌套越深,意味着代码的复杂度越高,越难维护。有的时候,自己不觉得,别人接手的话,会很痛苦。这大概,是sonarqube这个规则的出发点。所以,依据这个规则提示,重构代码,如果层次要越过3层了,就赶紧写个新的方法,这样子避免一个方法中的嵌套越过3层。依据09年在人力资本职场所学到的经验,通常,人类不擅长处理5个因子以上事情,能控制在3个因子里,效率更高。所以,我们尽量拆解拆解,像sonarqube这个嵌套检查规则,不要超过3层。

2.驼峰命名

如果写习惯了C#的BLL,跑到java里,写bll,是不是感觉很别扭,按sonarqube的提示去修改吧,也不用太刻意想,跑sonarqube,这些小细节,都能查出来!编码规范就是这么被执行的,不用人来review代码规范,用工具就统一了。

3.判断的时候值在前还是变量在前

sonarqube会要求你把值写在前面,这里面有什么故事么?可以使用公众号回复why查看原因。

4.catch到exceptiony请写日志

悄悄的吞掉ex,那怎么行,sonarqube不会给通过的,代码都发布不了。想想也是,有了异常,连个日志都不写,是有点不妥。

5.不关闭文件操作网络操作可不行

sonarqube会告诉你,有文件流操作没有关闭,让补上。一般网上找代码,拿过来用,都可能会有这啊那的问题,拿sonarqube做个检查,是再好不过的。

6.没用的参数去掉

如果定义了多个参数,但是有的参数却不使用,sonarqube,会要求你删除掉。

7.定义了本地变量不使用

不行,sonarqube不允许。

8.定义了一个本地变量,用了一次

不行,sonarqube提示你,是不是可以省下这个本地变量

9.是不是使用lambda

sonarqube会跟你说,有更简洁的lambda写法,请换个写法

10.你看,那对括号可以省掉

如果在filter,多加了括号,sonarqube会跳出来,告诉你,省下这两个括号。

11.哎呀,重复代码

sonarqube控制代码重复,重构,再重构,达到sonarqube的要求。这个地方最最让人揪心的是单元测试与重复代码的前世今生。回复powermock查看我写单元测试的经验心得。

12.布尔条件请合并合并

sonarqube告诉你,不要秀两个if,合并成一条吧。

还有很多很多sonarqube的Coding提示,内置了很多优秀的coding风格,说这么多,也是希望每一位朋友都能重视代码质量,都能使用一下sonarqube,相信你也会喜欢这款代码质量检查工具,对于公司,对于团队,对于个人来讲,都是一个非常不错的研发质量保证工具。

发表在 未分类 | 留下评论

大学、中小学校园图书馆如何接入图书云平台

图书云是免费图书共享平台,任何个人、企事业单位都使用或接入到图书云平台。校园图书馆接入图书云的几大好处:

一、无限可能的藏书量

通过图书云平台,每位学生都可以是一个私人图书馆馆长,虽然单个学生的图书有限,但是学生多,整体的藏书量相当可观。

二、更加丰富图书品类

与校园图书馆每年有仅有限的经费支撑不同,学生的藏书量有学习成长动力支撑,有学生的兴趣爱好支撑。多元化的品类,更加丰富的图书品类,也能与校图书馆形成良好的互补机制。

三、更加新鲜的图书

有没有一种感觉,学校的图书偏老偏旧,市场上都不再使用或落伍的技术占满墙。你能想像满墙满墙的《delphi从入门到精通》么?学生的藏书,不受学校采购计划等各种因素影响,世界之么大,说买就买。学校就不能这么任性。

四、微信图书馆免费开启

通过图书云的校园图书馆解决方案,每个学校都可以有快速建立起微信图书馆,通过微信小程序为学生提供更加便利的图书检索、借阅通知、发送催还提醒、预约借阅等等功能。

接入流程与步骤

图书云校园解决方案包括两大块,共享图书+校园微信书馆,均为免费提供。接入流程与步骤如下:

1、联系图书云运营微信13439975582,洽谈接入意向

2、签定接入合作意向

3、对接系统

4、上线试运营2个月

5、正式上线

图书云公众号二维码
图书云公众号二维码

图书云为共享图书平台,向附近的朋友借书、同事、群友、俱乐部好友借书!图书云让小伙伴们享受便捷的私人移动图书馆服务,每个人都能将自己的闲置图书分享给身边的小伙伴,打造自己的小小图书馆!同时,也能通过图书云发现附近自己喜欢看的图书!

感谢以下赞助商对图书云的支持:

发表在 未分类 | 留下评论

图书云1.1.3.7校园图书共享优化版上线啦 简化流程,减少输入量 使用图书云校园图书共享功能 开启有智慧的青春校园读书生活

每个版本的背后,都有一个……一个故事!图书云1.1.3.7校园共享图书优化版基于海医学院实战经验总结而来。依据改版之前,要想加入图书云校园图书共享,需要输入手机号姓名,有些繁琐。改版后,不再需要输入手机号与姓名,加入后,可以通过图书云公众号沟通,无需花费短信费或电话费。

化繁为简

本次改版,不仅是学生群体使用体验的改版,更重要的是图书云运营策略的改变,更加开放的共享体验,更加简单的加入方式!简单,就是本次改版的核心理念!将原申请开通学校流程移除掉,学生可以自发开启校图共享!

体验方式

本次图书云1.1.3.7版本已经于2019年6月10日完成发布,全网均可直接使用!对于使用上的建议也可以随时通过图书云公众号反馈,也许你所想的的功能,你想要的体验就是下一个版本的主打。

抢前体验

图书云1.1.3.8会带来哪些新鲜的功能,带来哪些惊喜呢?欢迎加入图书云内测体验,请联系微信13439975582抢内测名额,请注明:图书云内测名额。

图书云公众号二维码
图书云公众号二维码

图书云为共享图书平台,向附近的朋友借书、同事、群友、俱乐部好友借书!图书云让小伙伴们享受便捷的私人移动图书馆服务,每个人都能将自己的闲置图书分享给身边的小伙伴,打造自己的小小图书馆!同时,也能通过图书云发现附近自己喜欢看的图书!

感谢以下赞助商对图书云的支持:

发表在 未分类 | 留下评论